

Yazılım üretimindeki hızlanma, kurumların kimlik bilgisi envanterini tutma kapasitesini geride bırakıyor. GitHub COO’su Kyle Daigle, platformda 2025’in tamamında yaklaşık 1 milyar commit görülürken bu sayının Ağustos 2026’da 2,9 milyara çıktığını, yıllıklandırılmış hızın da 2026 raporlama yılı için 14 milyarın üzerine çıktığını söyledi.
Aynı tablo güvenlik tarafında da görülüyor. GitHub’ın mühendislik ekibi, agentic development’in ivme kazanmasıyla birlikte artık 10 kat ölçek için değil, bugünün 30 katı ölçeği hedefleyen bir mimari üzerinde çalıştığını açıkladı. Yazılım arttıkça altyapı, entegrasyon ve otomasyon da çoğalıyor; bunların her biri bir yere kimlik doğrulamak zorunda kalıyor.
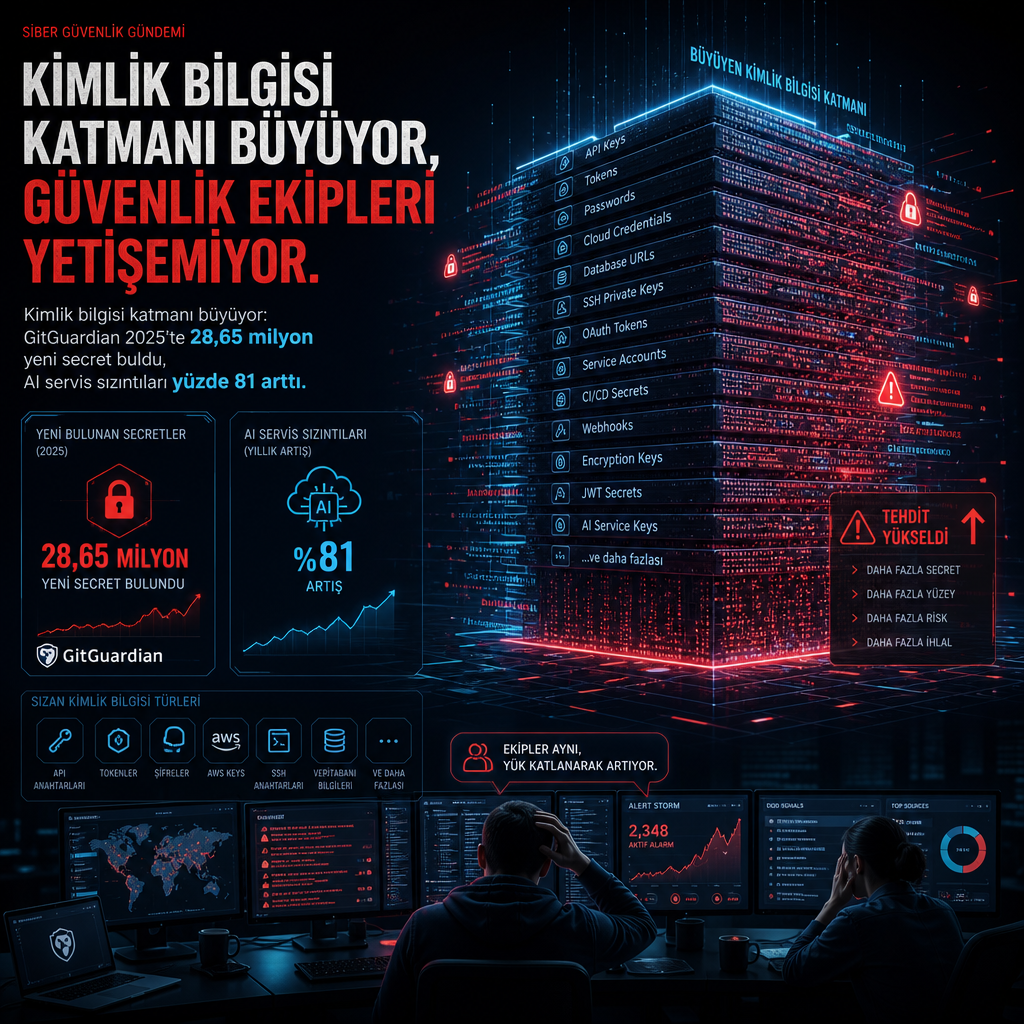
GitGuardian’ın 2025 verilerine göre kamuya açık GitHub commit’lerinde 28,65 milyon yeni hardcoded secret tespit edildi. Bu rakam bir önceki yıla göre yüzde 34 artış anlamına geliyor. Yapay zekâ servisleriyle ilişkili sızan kimlik bilgileri ise yüzde 81 yükseldi.
Şirketin yaklaşımı, genişleyen bu katmanı üç adımda ele alıyor: tespit, düzeltme ve önleme. Ancak zincirin ilk halkası yine keşif. Hangi kimlik bilgilerinin gerçekten mevcut olduğu, nereye yayıldığı ve ne tür erişim verdiği bilinmeden sonraki adımlar sağlıklı yürümüyor.
Kimlik bilgisinin sınırı, bulunduğu yere göre değişiyor
Kimlik bilgisi katmanı; insanlar, uygulamalar, altyapı ve servisleri birbirine bağlayan tüm credential’ların toplamını ifade ediyor. Bu katmanın çevresi bir güvenlik duvarı gibi sabit değil, credential’ların izlediği yol kadar genişliyor.
Bir geliştirici onaylı bir bulut hesabı içinde secret oluşturabiliyor, aynı anahtar daha sonra düz metin halinde bir depoya ya da paylaşılan bilgi tabanına düşebiliyor. Başka bir secret onaylı bir vault içinde tutulurken kopyası geliştiricinin dizüstü bilgisayarında düz metin kalabiliyor. Kimi kimlik bilgileri ise güvenlik ekiplerinin normalde görmediği alanlarda, kişisel projelerde ya da yeni kullanılan bir yapay zekâ servisinde üretilebiliyor. Kodlama ajanlarına erişim verilen “citizen developer” kitlesinin büyümesi bu alanı daha da genişletiyor.
GitGuardian’ın State of Secrets Sprawl 2026 araştırması, yüzeyin ne kadar yayıldığını da ortaya koyuyor. İç depoların, kamuya açık depolara kıyasla en az bir secret barındırma ihtimali yaklaşık altı kat daha yüksek bulundu. Secret vakalarının yaklaşık yüzde 28’i ise kaynak kodu depolarının dışında, işbirliği ve üretkenlik sistemlerinde başladı.
Bu durum güvenlik ekiplerinin önüne temel bir keşif sorunu çıkarıyor. Her tarayıcı, vault, depo ya da uç nokta yalnızca gördüğü parçayı tanımlayabiliyor. Kurumun ise bütün popülasyonu birlikte değerlendirecek bir yönteme ihtiyacı var.
Kaynak kontrol sistemleri hâlâ kritik, çünkü hardcoded kimlik bilgileri kalıcı iz bırakıyor. Bir dosyanın güncel sürümünden silinen bir credential, Git geçmişinde yaşamaya devam edebiliyor. Kopyalar başka branch’lere ya da depolara yayılabiliyor. Secret kamuya açık hale geldiğinde değer kurumun kontrolünden çıkıyor ve bunu anında fark etmek çok zorlaşıyor.
İç depolar normal iş akışında kullanılan kimlik bilgilerini gösteriyor. Bunlar bulut ortamlarına ve kurum içi servislere erişim için kullanılan secret’ları da içeriyor. İşbirliği sistemleri ise farklı bir katmanı açığa çıkarıyor. Sorun çözmek için ticket içine yapıştırılan credential’lar, devir teslim sırasında sohbet kanallarından akabiliyor ve iş bittikten sonra bile aranabilir halde kalabiliyor.
Geliştiricilerin dizüstü bilgisayarları ise bu resmin en yoğun alanlarından biri. Uzun süre yerel ortam dosyaları, komut satırı önbellekleri ve shell geçmişi, kimlik bilgilerini barındırmak için normal kabul edildi. Ancak 2025’in sonlarında Shai-Hulud ve S1ingularity gibi yeni infostealer dalgaları geliştirici laptop’larını doğrudan hedefe ve tedarik zincirine giriş noktasına çevirdi.
Bu yüzden her laptop kimlik bilgisi katmanının parçası sayılıyor ve üzerindeki secret’ların haritalanması gerekiyor. Depo taraması kaynak koda ulaşmış kimlik bilgilerini gösteriyor. Kamu izleme, kurumsal depoların dışındaki açıklıkları ortaya çıkarıyor. Uç nokta keşfi ise merkezi sistemlere hiç girmemiş olabilecek secret’ları belirliyor. Katman ancak bu bakışlar birleştirildiğinde görünür hale geliyor.
AI ajanları ve dizüstü bilgisayarlardaki yoğunluk
Geliştirici uç noktaları artık yalnızca insanlar tarafından kullanılmıyor. Kodlama ajanları dosya okuyabiliyor, komut çalıştırabiliyor ve dış servislerle etkileşime girebiliyor. Model Context Protocol bağlantıları bu ajanlara ek araçlar açabiliyor. Her bağlantı, kimlik doğrulama ve yetkilendirmenin yapılması gereken yeni bir nokta anlamına geliyor.
GitGuardian’ın Shai-Hulud 2 tedarik zinciri kampanyası sırasında ele geçirilen sistemler üzerinde yaptığı analiz, bu makinelerdeki credential yoğunluğunu da gösterdi. Araştırmacılar 6.943 ele geçirilmiş sistemde 33.185 benzersiz secret tespit etti. Ele geçirilen makinelerin yüzde 44’ünde 10’dan fazla secret bulundu. Yüzde 5’lik bölümde ise sayı 100’ü aştı.
Aynı raporda, AI ajanlarının nasıl kimlik doğruladığına dair yeni bir açık da yer aldı. 2025 boyunca kamuya açık MCP yapılandırma dosyalarında 24.008 benzersiz secret görüldü; bunların 2.117’si doğrulanabilir şekilde geçerliydi.
Bir güvenlik ekibi depoları taradığında depolar hakkında çok şey öğrenebiliyor. Buna karşın kodun oluşturulduğu, test edildiği ve dış sistemlere bağlandığı makinelerde yaşayan credential’lara dair görünürlük sınırlı kalıyor. Yapay zekâ ajanları bu erişimle beklenmedik işlemler de yapabiliyor. Kötüye kullanım saldırganlardan gelebiliyor; aynı şekilde yapay zekânın şaşırtıcı bir adım atıp üretim veritabanını silmesi gibi istenmeyen sonuçlar da doğabiliyor. Güvenlik ekipleri riskin ne olduğunu anlayabilmek için bu ajanların tam olarak neye erişebildiğini bilmek zorunda.
Keşif yalnızca secret’ı bulmakla bitmiyor; etrafındaki bağlam da gerekiyor. En temel sinyallerden biri geçerlilik. Sorun şu ki, çoğu secret olması gerekenden çok daha uzun süre geçerli kalıyor. İdeal senaryoda credential tam zamanında üretilip kullanım sonrası süresi dolmalı. Ancak GitGuardian, 2022’de geçerli olduğu doğrulanan credential’ları yeniden test ettiğinde bunların yüzde 64’ünün Ocak 2026’da hâlâ geçerli olduğunu gördü.
Yani bir secret, ilk sızıntıdan yıllar sonra bile saldırganın işine yarayabilir. Bulunduğu yer de risk değerlendirmesini değiştiriyor. İç depoda bir kez görülen bir credential ile bir dizüstü bilgisayarda başlayıp ardından kamuya açık depoya taşınan aynı credential aynı risk geçmişine sahip değil. Her yeni görünüm, ona erişmiş olabilecek kişi ve sistemlerin sayısını artırıyor.
Credential fingerprinting, aynı secret’ın farklı görünümlerini tek bir kayıt altında birleştirebiliyor. Aynı secret’ın yedi ayrı tespiti, yedi kayıt değil, yedi kez görülen tek bir credential olarak tutuluyor. Bu yaklaşım envanteri daha doğru hale getiriyor ve ne kadar yayıldığını daha net gösteriyor.
Sahiplik bilgisi de ayrı bir katman oluşturuyor. Güvenlik ekiplerinin hangi kullanıcı, iş yükü ya da uygulamanın o credential’a dayandığını bilmesi gerekiyor. Böylece bulgu, erişimi yöneten ekiple ilişkilendirilebiliyor; yalnızca kim oluşturdu sorusu değil, hangi politika ve yönetişim kapsamına girdiği de netleşiyor.
Yetki kapsamı ise credential’ın ne yapabildiğini ve taşıdığı tehlikeyi ortaya koyuyor. Yalnızca bir geliştirme servisine bağlı credential ile geniş yönetici yetkilerine sahip bir üretim credential’ı aynı risk düzeyinde değil. Geçerlilik ve yetki bilgisi birlikte okunduğunda, hangi bulgunun önce ele alınması gerektiği daha netleşiyor.
Bağımlılıklar da resmin önemli bir parçası. Bir credential yüksek derecede açığa çıkmış olabilir ama kritik iş yüklerini de ayakta tutuyor olabilir. Bu ilişkileri anlamak, kurumun daha sonra o credential’ı güvenli biçimde döndürmek ya da iptal etmek için ihtiyaç duyacağı bilgiyi sağlıyor. Keşif, bu bağlamla zenginleştirilmiş bir credential kaydı üretmeli.
Kurumsal yapılarda secrets-management programları zaten bulunabiliyor. Bu sistemler, yönetim altındaki credential’lar hakkında değerli bilgiler sunuyor; neyin saklandığını, kimin erişebildiğini ve secret’ın nasıl kullanıldığını gösterebiliyor. Daha geniş kimlik bilgisi katmanı haritalandığında ise bu kapsamanın ne kadar eksiksiz olduğu ortaya çıkıyor.
Örneğin bir şirketin onaylı vault’larında 50.000 credential bulunabilir. Buna rağmen binlercesi düz metin halinde depolarda, geliştirici uç noktalarında ya da işbirliği sistemlerinde duruyor olabilir. Raporlama tarafında ise kurum, yalnızca bildiği secret’ların muhasebesini tutuyor olur. Planlı akışların dışında oluşturulanlar görünmez kalır. Bazı credential’lar vault içindeki mevcut değerlerle aynı olabilir, bazıları ise onaylı hiçbir yöneticinin dışında tamamen ayrı bir yerde yaşayabilir.
Bu yüzden güvenlik ekiplerinin ne kadar credential’a sahibi olduğunu, kaç aktif credential’ın yetkilerle ve bağlı iş yükleriyle eşleştiğini ve hangilerinin kamu ortamına taşındığını bilmesi gerekiyor. Bu ölçümler ise önce popülasyonun keşfedilmesine bağlı.
Software üretimi hızlandıkça saldırganların hızı da artıyor. GitGuardian’ın araştırmaları, inceledikleri dönem boyunca secret ifşasının aktif geliştirici sayısına göre 1,6 kat daha hızlı arttığını gösteriyor. CrowdStrike’ın verilerine göre 2025’te ortalama eCrime breakout time 29 dakikaydı; gözlenen en hızlı vakada yanal hareket 27 saniyede gerçekleşti.
Bu tablo, savunmanın insan hızına değil makine hızına göre kurulması gerektiğini gösteriyor. Reaksiyon süresi daralırken yalnızca daha hızlı tepki vermek yeterli olmuyor; önleme tarafına kayış gerekiyor. Bunun için de kurumun hangi secret’ları korumaya çalıştığını, nerede sızıntı riski bulunduğunu ve kimlik bilgisi katmanının gerçekte ne kadar genişlediğini bilmesi şart.
GitHub’ın 2025’te yıllık 1 milyar commit düzeyinden Ağustos 2026’da 2,9 milyara çıkması, haftada yüz milyonlarla ölçülen bir yazılım hacmine işaret ediyor. Şirketin 30 kat ölçek için hazırlık yapması da aynı yönü doğruluyor. Her yeni uygulama, ajan ve entegrasyon kimlik bilgisi katmanını biraz daha genişletiyor.
Bu nedenle güvenlik ekiplerinin de aynı hızda genişleyebilen bir görünürlüğe ihtiyacı var.