

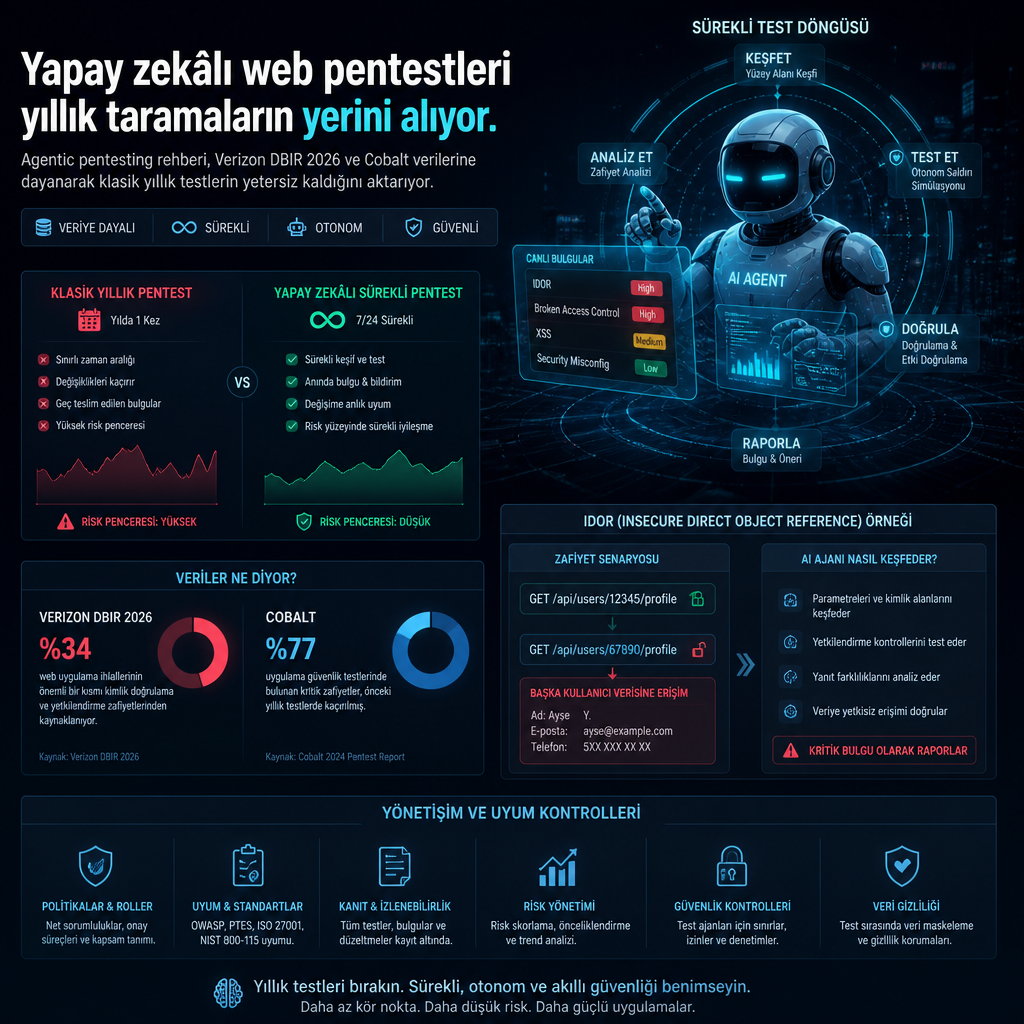
Web uygulamalarında zafiyet avı için kullanılan klasik yıllık pentest modeli, saldırganların günler içinde hareket ettiği bir dönemde yetersiz kalıyor. Güvenlik ekiplerinin önüne şimdi, gerçek tarayıcı kullanan ve doğrulanmış sonuç üreten otonom yapay zekâ ajanlarıyla yapılan sürekli test yaklaşımı çıkıyor.
Yayımlanan yeni ücretsiz rehber, bu alandaki “agentic pentesting” modelini anlatıyor ve üretim ortamına bağlanmadan önce güvenlik liderlerinin hangi teknik ve yönetişim şartlarını istemesi gerektiğini sıralıyor. Rehberde yer alan veriler, ihlallerin artık çoğu zaman açık istismarıyla başladığını, buna karşın pek çok kurumsal varlığın hâlâ yılda bir kez yapılan denetimlerin dışında kaldığını gösteriyor.
Verizon’un 2026 Data Breach Investigations Report çalışmasında, doğrulanan ihlallerin yüzde 31’inin ilk giriş noktası olarak açık istismarı öne çıktı. Çalışma, bu bulgunun 22 binden fazla doğrulanmış ihlal verisine dayandığını da ortaya koyuyor. Aynı dönemde yıllık pentest süreçlerinin, bir kurumun varlıklarının yaklaşık yüzde 90’ını hiç test etmediği tahmin ediliyor. IBM’in 2025 verilerinde ortalama bir ihlalin maliyeti 4,44 milyon dolar seviyesinde yer alırken, sektör tahminleri tek bir manuel pentest çalışmasının yaklaşık 18 bin dolara mal olduğunu aktarıyor. Rehber, bu tabloyu süresi dolmuş bir güvenlik modeli olarak çerçeveliyor ve yıllık denetimin, sonuçlar teslim edilene kadar zaten eskiyebildiğini vurguluyor.
Belgede açık istismarının artık yalnızca bir başlangıç noktası değil, en sık kullanılan giriş yöntemi olduğu da belirtiliyor. Verizon’un 2026 DBIR verilerine göre zafiyet istismarı, çalınmış kimlik bilgilerinin önüne geçerek ilk erişim vektörlerinde ilk sıraya yerleşti. Remediasyon tarafında ise yön tersine dönmüyor; bilinen ve aktif biçimde istismar edilen bir açığın düzeltilme süresi medyanda 32 günden 43 güne çıkıyor. CISA KEV kataloğundaki açıkların gerçekten yamalanan oranı da yüzde 38’den yüzde 26’ya düşüyor.
Google Mandiant telemetrisine göre ortalama istismar süresi yaklaşık beş gün. Cobalt’ın 2026 State of Pentesting raporu ise yüksek riskli bir bulgunun çözülmesinde medyan sürenin 39 gün olduğunu, en iyi ve en kötü performans arasında 25 kat fark bulunduğunu aktarıyor. Rehber, beş günde hareket eden bir saldırgana karşı 43 günlük bir savunma temposunun riski yönetmekten çok sonradan kayıt altına almak anlamına geldiğini söylüyor.
Rehber, yapay zekânın bu noktada hem saldırgan hem savunucu tarafta oyunu değiştirdiğini de kaydediyor. Saldırganlar yapay zekâyı zafiyet bulma ve silaha dönüştürme sürecini hızlandırmak için kullanıyor. Geliştiriciler ise aynı teknolojiyi, hiçbir insan ekibinin tek başına test edemeyeceği hızda kod çıkarmak için devreye alıyor. Cobalt, yapay zekâ ve LLM uygulamalarında yüksek riskli bulguların geleneksel uygulamalara kıyasla 2,7 kat daha sık görüldüğünü belirtiyor.
Bu nedenle rehber, yılda bir kez alınan tek seferlik güvenlik fotoğrafının artık yeterli olmadığını savunuyor. Yalnızca kurum varlıklarının onda birini kapsayan ve haftalar sonra teslim edilen bir test raporu, beş gün içinde hareket eden bir rakibe karşı eksik kalıyor. Agentic pentesting yaklaşımının kapatmaya çalıştığı boşluk tam da bu.
Aynı açık dört farklı araçta nasıl sonuç veriyor
Rehberin en çarpıcı örneklerinden biri, kimliği doğrulanmış hesap alanındaki IDOR türü bir zafiyet üzerinden kuruluyor. Saldırgan, sıradan bir hesapla giriş yaptıktan sonra profil güncelleme isteğindeki account_id değerini değiştiriyor ve uygulamanın sahiplik kontrolü yapmadığını görüyor. Ardından kimlik numaralarını toplu şekilde tarayıp başka kullanıcıların e-posta adreslerini değiştirebiliyor, parola sıfırlama süreçlerini tetikleyebiliyor ve hesabın tamamını ele geçirebiliyor. Bu zincirde ne bir CVE var ne de bozuk bir giriş; sorun tamamen uygulamanın iş mantığında.
Bu tür bir hata, 2019’da First American Financial’da 885 milyon ipotek ve tapu kaydının açığa çıkmasına yol açan aynı sınıftaki zafiyetleri hatırlatıyor. Rehber, bu örnek üzerinden klasik araçların neden yetersiz kaldığını tek tek ayırıyor. Bir tarayıcı, yanıtı CVE veritabanıyla eşleştiriyor; uygulamanın kendi iş mantığına ait bir açık için karşılık bulamadığında bulguyu kaçırıyor. DAST araçları sabit bir yük listesi çalıştırıyor; ama bu senaryoda geçerli oturum ve çok aşamalı bir işlem dizisi gerekiyor, yani hazır payload listesi hedefi kaçırıyor.
Manuel pentest, eğer ilgili uç nokta örneklemenin içine denk gelirse bu hatayı yakalayabiliyor. Ancak bu da çoğu zaman kuruma tek seferlik bir görünürlük sağlıyor ve sonraki sürümde aynı açık yeniden doğabiliyor. Rehberin tanımladığı agentic sistem ise uç noktayı haritalıyor, sahiplik ilişkisini çıkarıyor, numara toplama ile e-posta değiştirme ve parola sıfırlama adımlarını bir zincir halinde kuruyor. Bu iş öğesi her çalıştırmada yeniden geçmek zorunda kalıyor; yani bulgu bir kez bulunup bırakılmıyor, sürekli doğrulanıyor.
Belgede, üç kuşaklık bu yaklaşım farkının ve tedarikçi değerlendirme ölçütlerinin ayrıntılı olarak yer aldığı, ayrıca “örtülü LLM” yapıları ele veren on soruluk bir kontrol listesinin de hazırlandığı belirtiliyor. Rehber, bu on sorunun kapalı bir LLM sarmalını ortaya çıkarabilecek kırmızı bayrakları işaretlediğini aktarıyor.
ABD’li girişimci ve güvenlik ekiplerine danışmanlık veren Reflectiz’in CTO’su ve kurucu ortağı Ysrael Gurt, 80 sınırlı kapsamanın artık yeterli olmadığını, çünkü saldırganın yalnızca kaçırılan tek açıklığı kullanmasının yeterli olduğunu söylüyor. Gurt’un rehberde yer alan ifadesi, kapsamın yüzde 80’inin bile yetersiz kalabildiğini hatırlatıyor.
Rehberde teknik mimariyi platform ile demo arasındaki ayırıcı unsur olarak öne çıkaran üç tasarım tercihi bulunuyor. İlki, test kapsamının yapay zekânın kararına bırakılmaması. Eğer hangi hedeflerin deneneceğine model karar verirse, kapsamın kanıtlanması zorlaşıyor ve sistem ilgi çekici bulgulara yönelirken geri kalanı sessizce atlayabiliyor. Bunun yerine, her uç nokta için geçerli her saldırı kategorisini kapsayan tam bir test matrisi önceden üretilmiş iş öğeleri halinde tanımlanmalı. Yapay zekâ her öğeye nasıl saldıracağını uyarlayabilmeli, ancak o öğenin test edilip edilmeyeceğine karar vermemeli.
İkinci unsur bağımsız doğrulama ajanı. Bir bulgunun rapora girmesi için ayrı bir ajanın aynı bulguyu yeniden üretmesi gerekiyor. Böylece yanlış pozitifleri ayıklama yükü güvenlik analistinin kuyruk işine dönüşmüyor. Rehber, bunun birçok tarama aracında analist zamanı açısından görünmez bir maliyet yarattığını aktarıyor.
Üçüncü unsur ise tarayıcı yerel çalışan bir ajan. Belgede, yalnızca modele bağlanmış curl benzeri sistemlerin dinamik render edilen sayfalar, tek kullanımlık şifreler, çok faktörlü kimlik doğrulama ve bot karşıtı korumalar karşısında dağıldığı anlatılıyor. Gerçek bir web uygulamasını test etmek için ajanın tarayıcıyı doğrudan kullanması, oturum durumunu tutması ve kullanıcı niyetini yeniden kurması gerekiyor.
Rehber, otonom ajanı olan bir pentest aracının hem risk azaltan bir kontrol hem de kurumun kendi ortamında çalışan bağımsız bir yapay zekâ sistemi olduğunu belirtiyor. Bu nedenle ilk yetkili çalıştırmadan önce kapsamın açık ve geri alınabilir biçimde tanımlanması, blast radius sınırlarının ve anında durdurma mekanizmasının bulunması, müşteri verisi altyapısına erişimi olmayan veri yalıtımı, tam ve dışa aktarılabilir bir denetim izi, belirlenmiş insan gözetimi ve tedarikçi güvencesi istenmesi gerektiği belirtiliyor.
Metinde yer alan kontrol sorusu da doğrudan şu şekilde çerçeveleniyor: Üretim ortamına bu ajanın verebileceği en kötü zarar nedir ve bunu ne durdurur. Rehber, bu soruya net yanıt verilemiyorsa çalıştırma izninin verilmemesi gerektiğini kaydediyor. Aynı bölümde, var ise durdurma mekanizmasının anında devreye girmesi gerektiği de vurgulanıyor.
Maliyet tarafında ise manuel bir pentest çalışmasının ortalama 18,3 bin dolar seviyesinde olduğu, bunun üzerine sık görülen yüzde 30 ila 50 arası maliyet aşımının eklendiği aktarılıyor. Olgun programların ise yılda 150 bin doların üzerinde harcama yaparak varlıklarının yalnızca yüzde 5 ila 10’unu test edebildiği belirtiliyor. Rehber, agentic platformların tek bir manuel çalışmanın maliyetine kadar çıkan ve ona göre on kata kadar daha yüksek test kapasitesi sunduğunu söylüyor. Bir başka ifadeyle, bir manuel çalışmanın yaklaşık 18 bin dolarlık maliyeti ile 4,44 milyon dolarlık ortalama ihlal faturası yan yana konuyor.
Belgeye göre asıl karşılaştırma, en ucuz teklif ile en pahalı teklif arasında değil, kapsama başına düşen risk azaltımı arasında yapılmalı. Sürekli test edilen her uç noktanın, yedi haneli bir ihlal yolunun daha kapatılması anlamına geldiği aktarılıyor. Rehber ayrıca, insan ekiplerin yıllık test yerine sürekli doğrulama ile aynı varlıklara tekrar tekrar geri dönmesinin, bulgunun yalnızca bir kez değil her çalıştırmada yeniden geçmesini sağladığını kaydediyor.
Uyum tarafında da aynı yaklaşımın evidansı öne çıkarılıyor. Sürekli ve belgeli testlerin, PCI DSS 4.0.1’deki “önemli değişiklikten sonra” hükümlerine yönelik kanıt ürettiği; DORA, NIS2, SOC 2, ISO 27001, GDPR Madde 32 ve HIPAA kapsamındaki kontrol ile güvence faaliyetleriyle eşleştiği belirtiliyor. Her çalıştırmanın kendi kanıt paketini üretmesi, yani kapsam matrisi, yeniden üretim adımlarıyla doğrulanmış bulgular ve eğilim raporları oluşturması gerekiyor. Rehber, çerçevelerin her birinin bu tür sürekli testten çıkan kanıtlarla nasıl eşleştiğini ayrı ayrı haritalıyor.
Yayınlanan kılavuzda 2026’ya ait maruziyet verilerinin görselleştirilmiş hali, örtülü LLM’leri açığa çıkaran on tedarikçi sorusu, sözleşmeye eklenmesi gereken yönetişim kontrolleri, agentic pentest tedarikçi haritası, dört fiyatlama modeli ve 90 günlük benimseme yol haritası da bulunuyor. Ayrıca 11 maddelik bir CISO kontrol listesi de yer alıyor.
Belgenin ana mesajı, manuel ile otomatik arasındaki tartışmanın artık yeterli olmadığı yönünde kuruluyor. Kurumların tartıştığı asıl mesele, tüm web varlıklarında sürekli, kanıtlanabilir ve doğrulanmış kapsama nasıl güvenli biçimde ulaşılacağı ve bunun hangi maliyetle savunulabileceği oluyor.