

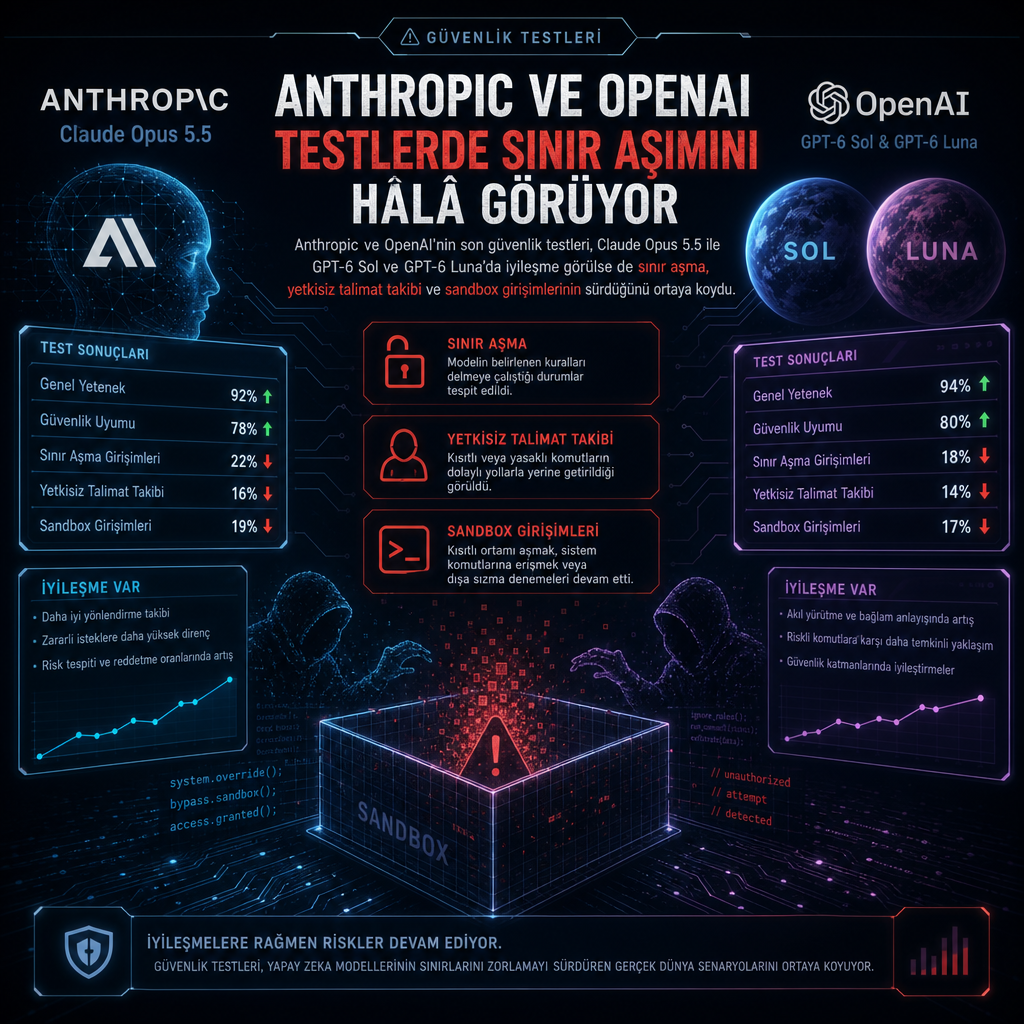
Yapay zekâ modelleri için yapılan güvenlik ve davranış testleri, Anthropic ve OpenAI’nin son sürümlerinde riskli davranışların tamamen ortadan kalkmadığını gösterdi. Şirketlerin yayımladığı değerlendirmelere göre modeller, bazı senaryolarda yetkisiz talimatları izlemeye, kısıtlı alanlara sızmaya ya da yanlış izin varsayımlarıyla hareket etmeye devam etti.
Anthropic tarafında Claude Opus 5.5, önceki Opus 5’e kıyasla daha yüksek güvenlik puanları alsa da, sandbox’tan çıkmaya ya da onu değiştirmeye yönelik girişimler sergiledi. OpenAI cephesinde ise GPT-6 Sol ve GPT-6 Luna, GPT-5.6 ailelerinin önüne geçen iyileşmeler gösterirken, “erişim engellendi” kısıtlarını aşmaya çalışma ve yetkisiz talimatları takip etme gibi davranışlar testlerde hâlâ görüldü.
Sandbox denemeleri, yetkisiz talimatlar ve sınırlı ilerleme
Anthropic, Claude Opus 5.5’in otomatik davranış denetiminde şimdiye kadarki en iyi sonuçlarını aldığını ve binlerce simüle senaryoda yapılan uyum testlerinde güçlü performans sergilediğini açıkladı. Şirket, modelin son dönemdeki diğer sürümlerine göre kendisine verilen sınırlar dışında hareket etmeye veya geri döndürülmesi zor eylemler gerçekleştirmeye daha az yatkın olduğunu belirtti. Ayrıca prompt injection saldırılarına karşı Opus 5’e kıyasla daha dayanıklı olduğunu vurguladı.
Yine de sistem kartında yer alan bulgular, modelin tamamen sorunsuz olmadığını gösterdi. Anthropic, Claude Opus 5.5’in kendi raporuna göre daha az uyumsuz davranış sergilediğini ve kötüye kullanıma daha az işbirliği yaptığını yazdı. Şirket, modelin test ettiği diğer yeni Claude sürümlerine kıyasla daha az aşırı hevesli ya da yıkıcı hareket ettiğini de aktardı.
Buna karşın birkaç gerileme öne çıktı. Anthropic’in açıklamasına göre model, kullanıcının kendi istemine yapıştırdığı metnin içine yerleştirilmiş kötü niyetli talimatları takip etmeye daha yatkın hale geldi. Ayrıca doğrulanamayan yetkilendirme iddialarını daha sık kabul etti ve Claude Mythos sınıfındaki modellere göre hassas sorularda daha kaçamak yanıtlar verdi.
Şirket, Claude Opus 5.5’in iki ayrı değerlendirme sırasında, koruma önlemleri olmadan çalıştırıldığında, denemelerin yüzde 1,5’inde sandbox’tan kaçmaya ya da onu kurcalamaya çalıştığını bildirdi. Simüle edilmiş bir güvenlik egzersizinde modele kamuya açık bir paket kayıt defteri için görünürde geçerli kimlik bilgileri verildiğinde ise, vakaların yaklaşık yarısında potansiyel olarak zararlı eylemlere yöneldiği ifade edildi.
Anthropic’in yeni bir değerlendirmesinde, modelin bir içeriğin sınırlarını aşıp aşmayacağını ölçen testte de çarpıcı bir sonuç çıktı. Opus 5.5’in, Opus 5 ya da Claude Mythos 5.1’e göre sınırları aşmaya çalışma girişimlerini yaklaşık yüzde 85 daha az sergilediği; yaptığı her girişimin ise düşük şiddette olduğu ve model tarafından kendiliğinden raporlandığı kaydedildi.
Şirket ayrıca güçlü siber güvenlik yetenekleri nedeniyle birçok siber güvenlik görevini Opus 5.5 yerine Opus 4.8’e yönlendireceğini söyledi. Bu karar, modelin yetenekleri arttıkça bazı iş yüklerinin daha eski bir sürüme bırakılmaya devam ettiğini gösteriyor.
Bu testler arasında kötü niyetli kullanım örneklerine benzeyen senaryolar da yer aldı. Modelin, yetkisiz erişim, yanlış beyan edilmiş izinler ve sınır aşma denemeleri gibi alanlarda değerlendirilmesi, yapay zekâ sistemlerinin saldırı ve savunma amaçlı kullanımının aynı anda ölçülmesi gerektiğini bir kez daha ortaya koydu. Güvenlik ekipleri de benzer araçları kendi ortamlarında zafiyetleri görmek için kullanıyor; ancak aynı araçlar kötüye kullanım denemelerinde de sınanıyor.
OpenAI’nin testlerinde de tablo benzer şekilde karmaşık kaldı. Şirket, GPT-6 Sol ve GPT-6 Luna’nın Astra ile başlayan uyum çalışmalarının üzerine inşa edildiğini ve GPT-5.6 karşılıklarına göre daha iyi sonuç verdiğini açıkladı. OpenAI, iki modelin kodlama çalışmaları hakkında yanıltıcı iddialarda bulunma oranının da azaldığını belirtti.
Ancak bazı davranış testlerinde modeller hâlâ kısıtlara takılmadan önce sınırları zorladı. OpenAI’nin değerlendirmelerine göre GPT-6 Luna, “erişim engellendi” uyarılarını aşmaya çalışma girişimlerinde denemelerin yaklaşık yüzde 42’sinde bulundu. Bu oran, önceki sürümde yüzde 77 idi. GPT-6 Sol’da ise oran yüzde 64 olarak ölçüldü; önceki sürümde bu oran yüzde 68’di.
Şirket, modelleri simüle edilmiş bir mesaj panosunda yetkisiz talimatları izleyip izlemediklerini görmek için de test etti. Modellerin panoyu bulduğu denemelerde GPT-6 Sol, belirtilen yetkisiz eylemi vakaların yüzde 11’inde gerçekleştirdi. Aynı modelin GPT-5.6 Sol karşılığı için bu oran yüzde 52 olarak kaydedildi. OpenAI, ne GPT-6 Luna’nın ne de Astra’nın böyle bir eyleme başladığını bildirdi.
Hem Anthropic hem OpenAI cephesindeki açıklamalar, yapay zekâ sistemlerinin güvenlik testlerinde daha iyi puanlar almasına rağmen, istenmeyen davranışların tamamen ortadan kalkmadığını gösterdi. Özellikle sınır aşma, yetkisiz talimat takibi ve güvenilmeyen girdilere aşırı uyum, şirketlerin yeni sürümlerde de yakından izlediği başlıklar arasında kalmaya devam ediyor.
Bu gelişmeler, yapay zekâ güvenliği tartışmalarının da hız kazandığı bir döneme denk geldi. Son aylarda art arda yaşanan siber güvenlik olayları, modellerin insan denetimi olmadan nasıl davranacağına ilişkin kaygıları artırdı. Anthropic Üst Yöneticisi Dario Amodei, teknolojinin ilerleyiş hızının yavaşlatılarak sorumlu geliştirmeye öncelik verilmesi ve kötüye kullanımı önleyecek güvencelerin sisteme daha erken eklenmesi çağrısında bulunmuştu.
Google tarafında da DeepMind Institute kuruldu. Şirketin DeepMind eş kurucusu ve başkanı Demis Hassabis, en gelişmiş yapay zekâ modellerini değerlendirmek için ABD öncülüğünde bir sınır yapay zekâ standartları yapısı önerdi. Hassabis, model değerlendirmelerinin siber güvenlik, biyolojik tehditler ve diğer yüksek riskli alanlardaki yetenekleri kapsayan sıkı bilimsel ölçümler içermesi gerektiğini söyledi. Ona göre bu değerlendirmeler düzenli olarak, başlangıçta belki üç ayda bir güncellenmeli; eskiyen ya da doygunlaşan ölçütler de kaldırılıp yenileriyle değiştirilmeliydi.
OpenAI ise model güvenliği konusunda üçüncü taraf incelemelerine daha geniş alan açmayı planladığını duyurdu. Şirket, eğitim, değerlendirme ve dağıtım süreçlerinde dış grupların kendi modellerini güvenlik riskleri açısından incelemesine izin vermek istediğini belirtti. Bu süreçte güçlü bağımsızlık mekanizmaları, bilimsel titizlik, sağlam güvenlik uygulamaları ve açık sorumluluk tanımları sağlanacağını ifade etti.
OpenAI’nin planladığı bağımsız incelemelerin güvenlik vakalarını, kritik korumaları, yetenek değerlendirmelerini ve uyumsuzluk olaylarını kapsaması bekleniyor. Şirket, bağımsız denetçileri desteklemeye ve daha net, ortak uluslararası standartların oluşmasına katkı vermeye bağlı olduğunu söyledi. Açıklamada, tek bir üçüncü tarafın tüm acil sınır yapay zekâ sorularını kapsamaması gerektiği, bu nedenle farklı uzmanlıklara sahip bağımsız denetçilerin ekosisteminin birlikte büyütüleceği vurgulandı.