

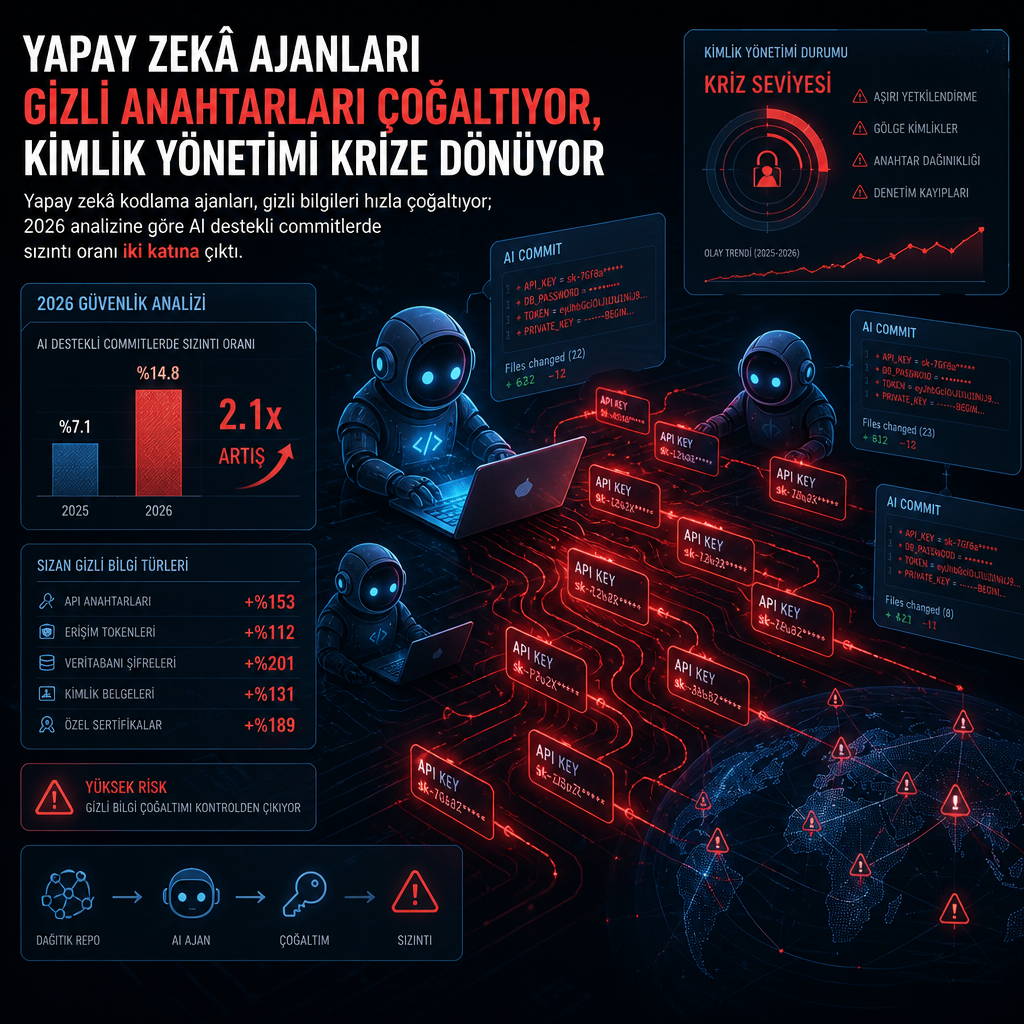
Yapay zekâ destekli kodlama ajanları, geliştirme ortamlarında saklı kalan API anahtarları, tokenlar ve servis hesaplarını görünür olmaktan çıkarıp daha hızlı yayılmasına yol açıyor. 2026’ya ilişkin yeni bir analiz, yapay zekâ yardımıyla yazıldığı belirlenen commitlerde gizli bilgi sızıntısının insan eliyle yazılanlara kıyasla yaklaşık iki katına çıktığını ortaya koydu.
İnceleme, en hızlı büyüyen sızıntı kategorilerinin de artık yapay zekâ servisleriyle bağlantılı olduğunu gösteriyor. Böylece yazılım geliştirmeyi hızlandırmak için kullanılan araçlar, aynı anda geliştiricilerin dayanmak zorunda olduğu anahtarların açığa çıkma hızını da artırmış oluyor.
Sorun yeni bir açık değil, ölçek değişti
Gizli bilgi saçılması, bir kuruluşun API anahtarları, tokenlar ve servis hesabı kimlik bilgilerini güvenilir biçimde envantere alamadığı ve döndüremediği durumlarda ortaya çıkıyor. Bu bilgiler kaynak kodunda gömülü kalabiliyor, yapılandırma dosyalarına yapıştırılabiliyor ya da hata takip kayıtlarına kopyalanabiliyor.
Güvenlik ekipleri yıllardır bu tabloyu tarayıcılarla, pre-commit kontrolleriyle ve sızıntı sonrası yapılan anahtar rotasyonlarıyla yönetmeye çalışıyor. Ancak yapay zekâ ajanları, yalnızca tespitin yeterli olmadığı boşlukları daha görünür hâle getiriyor.
Bu ajanlar yerel dosyaları okuyabiliyor, komut çalıştırabiliyor, API çağırabiliyor, Model Context Protocol yani MCP sunucularıyla konuşabiliyor ve yapılandırmayı değiştirebiliyor. Her yeni yetenek, bir kimliğin ihtiyaç duyduğu yeni bir kapı ve gizli bilginin yayılabileceği yeni bir yüzey anlamına geliyor.
Bu nedenle rapor, ajanlı yapay zekâ döneminde gizli bilgi saçılmasının bir model davranışı değil, Non-Human Identity yani insan olmayan kimlik meselesi olarak ele alınması gerektiğini söylüyor. Bir ajanın veritabanına sorgu atması, API çağırması ya da staging ortamına dağıtım yapması için arkasında bir yetkilendirme kimliği bulunuyor. Kuruluşlar, o özerk sistemin hangi işlemi yapacağını tek tek öngöremese de arkasındaki kimliğin nereye erişebileceğini kontrol edebiliyor.
Ajanlar bilgiyi nereden çekiyor, nasıl çoğaltıyor
Kodlama ajanlarını kullanışlı yapan şey, aynı zamanda risk yaratıyor: bağlama ihtiyaç duymaları. Bir ajanın projeyi bütün halinde okuyamaması, özellikle her işlem için yeniden onay almak zorunda bırakılması, sağladığı desteği ciddi biçimde sınırlıyor. Bu yüzden kurumlar, yapay zekâ kodlama ajanlarına kimlik bilgisi ve gizli verilere erişim verirken daha dar bir çerçeve çizmek zorunda kalıyor.
Geliştiriciler sık sık .env dosyalarına ve yerel yapılandırmalara kimlik bilgisi bırakıyor. Bunlar çoğu zaman geçmişteki bir hata ayıklama oturumundan kalıyor ve hiçbir zaman kaynak denetimine girmek üzere tasarlanmıyor. Geniş erişime sahip bir kodlama ajanı, analiz etmesi istenen uygulama koduyla birlikte bu dosyaları da okuyabiliyor. Üretim API anahtarı içeren bir yapılandırma dosyası ajan için de çalışma ortamının parçası sayılıyor; erişim açıkça sınırlandırılmadıkça, görevle ilgisi olmasa bile bu bilgi ajanın önüne gelebiliyor.
Bu durum, geliştirici iş istasyonlarına dair güvenlik varsayımlarını da değiştiriyor. Yerel düz metin kimlik bilgileri artık yalnızca geliştiricinin ve onları açıkça referans eden uygulamaların erişebildiği bir yerde durmuyor; aynı ortamda çalışan yazılım ajanları için de ulaşılabilir hâle gelebiliyor.
Ajanlar ve MCP sunucuları için hazırlanan kurulum yönergeleri de benzer bir risk taşıyor. Geliştiricilerin yapay zekâ uygulamalarını veritabanlarına, API’lere ve diğer dış sistemlere bağlamasını kolaylaştırmak için çoğu entegrasyon kimlik doğrulama istiyor. Kolaylık sağlamak için kimlik bilgisinin doğrudan bir yapılandırma dosyasına yapıştırılması yaygınlaşıyor. Bu dosya çoğu zaman sürüm kontrolüne girmediği için bilgi güvenli görünebiliyor. Oysa dosya yine de geliştirici makinesinde düz metin olarak kalabiliyor ve ajan, okuma yetkisi varsa buna erişebiliyor.
Tek bir gizli bilgi de çoğu zaman tek yerde kalmıyor. Aynı anahtar .env dosyasında, CI/CD değişkeninde ya da dağıtım arızası araştırılırken açılan bir Jira kaydında bulunabiliyor. Bir yapay zekâ kodlama ajanı bu sistemlere bağlandığında yeni bir risk doğuyor; çünkü bir anahtarın kopyalarından herhangi biri hâlâ çalışıyorsa, yalnızca depodaki kopyayı döndürmek sorunu çözmüyor.
Bu yüzden depo taraması tek başına yeterli olmuyor. Gizli bilgi olaylarının önemli bir bölümü kod depoları dışında, işbirliği ve biletleme araçlarında başlıyor. Depoda bulunan kopyayı değiştirmek, aynı kimlik başka bir yerde geçerliyse saldırgana hâlâ açık kapı bırakıyor.
Ajan hesapları da çoğu zaman gereğinden fazla yetkilendiriliyor. Bir ajanın işini yapabilmesi için yeterli erişime sahip olması gerekiyor ve bu da daha geniş izinlerin verilmesine yol açıyor. Prototip aşamasında hata çıkarmasın diye açılan izinler, süreç üretime geçtiğinde kalıcı hâle gelebiliyor. İlk niyet geçiciyken, yapılandırma yeniden gözden geçirilmediği için aynı yetkiler kullanıma devam ediyor.
Risk çok ajanlı sistemlerde daha da büyüyor. Birden fazla ajan için anahtar tutan bir orkestrasyon katmanı, kimliklerin zincirleme biçimde ele geçirilmesine neden olabilecek bir yapı kuruyor. Böyle bir durumda saldırgan, orkestratörün erişebildiği her şeye ulaşabiliyor.
Keeper Security’nin RSAC 2026 anketinde, katılımcıların yüzde 46’sı yapay zekâ destekli araçların kritik sistemlere ve hassas verilere erişimi olduğunu söyledi. Aynı ankette yüzde 76, bu kimliklerin ayrıcalıklı erişim politikaları altında tutarlı biçimde yönetilmediğini belirtti. Erişim verilse bile, bu seviyeye normalde eşlik etmesi gereken kontrollerin çoğu ortada görünmüyor.
Kuruluşlar neyi değiştirmek zorunda
Yapay zekâ kodlama araçlarını tamamen yasaklamak çoğu kurum için gerçekçi değil. Rapora göre buna zaten gerek de yok. Kuruluşların, yapay zekâ ajanlarını geliştirme ortamında çalışan bir başka kimlik olarak görmesi ve erişimi buna göre tanımlaması gerekiyor.
İlk adım, geliştirici ortamından statik kimlik bilgilerini çıkarmak. .env dosyalarında, MCP yapılandırmalarında ya da IDE ayarlarında saklanan gizli bilgiler yerine, ihtiyaç anında merkezi bir secrets management platformundan çekilen bilgiler kullanılmalı. Düz metin kimlik bilgisi iş istasyonunda bulunmuyorsa, ajan da onu oradan okuyamıyor.
İkinci adım, uzun ömürlü anahtarları kısa süreli ve otomatik dönen kimlik bilgilerle değiştirmek. Sızan statik bir anahtar aylarca, hatta yıllarca geçerli kalabiliyor. Dakikalar içinde sona eren ve belirli bir döngüyle rotasyona giren bir kimlik ise bu süreyi ciddi biçimde daraltıyor; saldırganın tüm kopyaları bulmasını gerektiren pencereyi küçültüyor.
Her ajana kendi kapsamı belirlenmiş kimliğini vermek de raporda öne çıkan başlıklardan biri. Paylaşılan servis hesapları, hangi işlemi hangi ajanın yaptığını ayırt etmeyi neredeyse imkânsız hâle getiriyor. Aynı zamanda her ajanın, içlerinden en geniş yetki gerektireninin seviyesine çıkmasına yol açıyor. Kuruluşların, her yapay zekâ ajanına yalnızca görevini yerine getirmek için gereken izinleri vermesi ve mümkün olduğunda bu izinleri geçici tutması isteniyor. Raporda, ajana bir yüklenici gibi davranılması gerektiği belirtiliyor; yani belirli kaynaklar ve belirli eylemler için tanımlı bir süre içinde yetki verilmesi kastediliyor.
Gizli bilgi yönetimi yalnızca kod depolarıyla sınırlı kalmamalı. CI/CD altyapısı, geliştirici iş istasyonları, MCP yapılandırmaları, biletleme sistemleri ve işbirliği araçları da kimlik bilgisi taşıyor. Tarayıcıların görmediği çok sayıda sızıntı da zaten bu yüzeylerde başlıyor.
Yüksek riskli işlemlerde insan onayı da korunuyor. Kimlik bilgisine erişim, üretim dağıtımları ve ayrıcalık değişiklikleri tamamen otonom hâle gelmemeli. Auto-approve modlarının, kapsamı açıkça tanımlanmış bilinçli bir politika kararı olarak ele alınması gerekiyor; bir geliştiricinin bir kez açıp bir daha bakmadığı varsayılan bir ayar olarak değil.
Kuruluşların hâlihazırda çalışan ajanları ve MCP sunucularını da envantere alması gerekiyor. Çoğu ortamda, bireysel geliştiricilerin denetimsiz biçimde kurduğu sandığından fazla ajan bulunuyor. Hangi ajanların çalıştığı, kime ait olduğu, hangi kimlikleri kullandığı ve bu kimliklerin nereye erişebildiği bilinmeden yönetim yapılamıyor.
Son adım, tüm ajan faaliyetlerinin kaydedilmesi ve denetlenmesi. İnsan kimliklerinde olduğu gibi insan olmayan kimlikler için de erişim izi gerekiyor. Bir ajanın hangi kimliği kullandığı ve hangi kaynaklara ulaştığı kayıt altına alınmazsa, olay müdahalesi bir ihlali yeniden kuramıyor; uyum denetiminde de bu boşluğu gösterecek kanıt kalmıyor.
Raporda çizilen ana çerçeve net: gizli bilgi saçılması bir yapay zekâ sorunu değil, kimlik sorunu. Yazılım geliştirme, kurumların yapay zekâyı en çok kullandığı alanlardan biri olmaya devam ediyor ve güvenlik ekiplerinin bunu yalnızca yasaklarla değiştirmesi beklenmiyor. Yapay zekâ ajanları gizli bilgi saçılmasını yaratmadı; birçok kurumun makine kimliği güvenliğinde zayıf olduğunu açığa çıkardı.
Bu nedenle hedef, ajanların karşılaştığı gizli bilgilerin çalınmaya değmemesini sağlamak. Gereksiz statik kimlikleri kaldırmak, kalıcı yetkileri ortadan kaldırmak, kimlik ömrünü kısaltmak, kimlikleri birbirinden ayırmak ve makine kimliklerinin nasıl kullanıldığını görünür tutmak gerekiyor. Daha fazla tarama, bilgi yayıldıktan sonra onu bulsa da sorunu çözmüyor; merkezi ve sıfır bilgi yaklaşımıyla kimliklerin nasıl saklandığı, kapsamlandığı ve süresinin nasıl dolduğu kontrol altına alındığında risk daralıyor.
Kaynak metinde, Keeper Secrets Manager’ın kurumların altyapı gizli bilgilerini merkezî biçimde korumasına, geliştirme akışındaki gömülü kimlik bilgilerini kaldırmasına ve sıfır güven, sıfır bilgi yaklaşımıyla kullanım kontrolü sağlamasına imkân verdiği aktarılıyor. Ajanlar daha hızlı çalışmayı sürdürüyor; ancak onların arkasındaki kimliklerin daha kısa ömürlü ve daha dar kapsamlı olması gerektiği vurgulanıyor.