

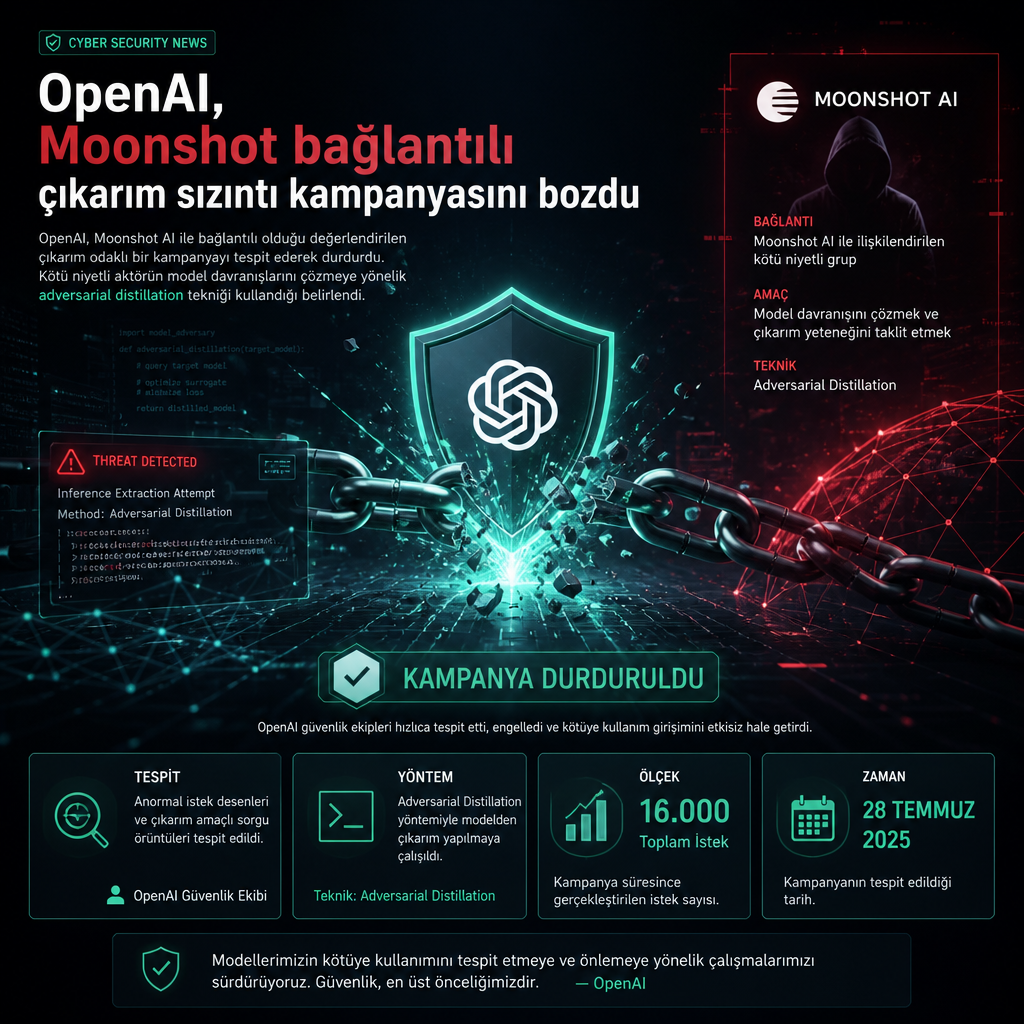
OpenAI, Temmuz ayının ilk haftasında başlayan ve yapay zekâ modellerinin “korumalı çıkarım” verilerini dışarı sızdırmayı hedefleyen bir kampanyayı durdurduğunu açıkladı. Şirket, faaliyetlerin Pekin merkezli Çinli yapay zekâ firması Moonshot AI ile bağlantılı kişilere atfedilen bir “çekirdek küme”den geldiğini bildirdi. Açıklamada bu değerlendirmeyi destekleyecek teknik kanıt paylaşılmadı; şirket bunu güvenlik gerekçeleriyle yapmış olabileceğini belirtti.
Kampanya doğrudan bir veri tabanı ihlali ya da şifre kırma girişimi değildi. OpenAI, operatörlerin şifrelemeyi aşmadığını, herhangi bir kullanıcı sohbet deposuna doğrudan erişmediğini ve altyapıya sızmadığını vurguladı. Şirketin ifadesine göre saldırganlar bunun yerine model etkileşimlerini manipüle etti ve korumalı çıkarım içeriğini, talepte bulunan kişinin görebileceği biçimlerde, koordineli ve ölçekli şekilde yeniden üretmeye çalıştı. OpenAI, bunun hizmet şartlarını ihlal ettiğini söyledi.
Temmuzda hızlandı, 28 Temmuz’da tamamen kesildi
Şirketin zaman çizelgesine göre faaliyet 1 Temmuz 2026’da başladı. İlk aşamada düşük hacimde ilerleyen girişimler, 24 ve 25 Temmuz’da belirgin biçimde arttı. Bu iki günde, 4 binden fazla kullanıcı üzerinden ilgili bir çıkarım çıkarma kalıbı taşıyan 16 bin deneme isteği kaydedildi. OpenAI daha sonra 15 binden fazla kullanıcıya yayılan bağlantılı “prompt-pattern activity” bulduğunu aktardı. Kampanya 28 Temmuz 2026’da tamamen bozuldu.
OpenAI bu yöntemi “adversarial distillation” olarak tanımladı. Şirketin kullandığı tanım, bir modelin çıktılarının sistematik ve izinsiz biçimde başka bir modeli eğitmek, yeniden üretmek ya da geliştirmek için kullanılmasını anlatıyor. OpenAI, saldırıda yer alan sahte hesapları kapattığını ve bu tekniğe karşı ek önlemler devreye aldığını da duyurdu.
Şirket ayrıca, başka bir kullanıcının şifrelenmiş çıkarımını elinde bulunduran bazı kişilerin bu veriyi geri oynatıp içeriği yeniden elde etmesini mümkün kılan bir “pathway”i kapattığını bildirdi. Buna ek olarak, çıkarımı açığa çıkarabilecek akışlı çıktıları tespit edip bekletecek kontrollerin sisteme eklendiğini söyledi.
OpenAI’nin anlattığı bu kampanya, model çıktılarını toplayarak başka bir modele aktarmayı amaçlayan, güvenlik önlemlerini aşmadan yetenek transferi sağlamaya çalışan bir istismar biçimi olarak öne çıkıyor. Şirket, bu tür işlemlerin yalnızca kullanıcıya görünen çıktıları değil, modelin görev çözerken izlediği düşünme izlerini de hedef aldığını vurguladı.
Şifreli çıkarım, modeller arasında taşınabilir hale gelmişti
Bu tabloyu besleyen teknik tartışma yeni değil. Ağustos 2026’da yayımlanan bir araştırmada, farklı oturumlar, kullanıcılar ve modeller arasında “şifrelenmiş çıkarım izlerinin” bir sağlayıcı ekosistemi içinde tamamen uyumlu ve birbirinin yerine geçebilir olduğu bir mimari zafiyet ortaya kondu. Araştırmacılar, bu yapının ölçeklenebilir bir deşifre jailbreak’i geliştirmek ve anti-distillation mekanizmalarını baypas etmek için kullanılabileceğini yazdı.
MATS Research, ELLIS Institute Tübingen ve Synk araştırmacıları, bir modelden alınan şifrelenmiş çıkarım izini aynı sağlayıcının daha zayıf ve daha az korunan bir modeline enjekte ederek, o modelin izi düz metin halinde çözmesini ve çıktıyı olduğu gibi üretmesini sağladıklarını anlattı. Araştırmacılar, daha yetenekli modeli doğrudan jailbreak etmeye gerek kalmadan bu sonuca ulaşıldığını belirtti.
Aynı çalışma, bu yöntemin büyük ölçekli özel veri sızdırma için kapı araladığını, kötü amaçlı yüklerin tamamen şifreli blokların içine gömülmesiyle görünmez prompt injection saldırılarına izin verdiğini ve modelin nihai, görünen çıktısı zararlı bir isteği reddetse bile çıkarım sürecinde saklanan tehlikeli bilgileri açığa çıkarabildiğini ortaya koydu.
OpenAI de korumalı çıkarımın modelin bir görevi nasıl çözdüğüne dair içgörü sunduğunu, bu nedenle bu bilgilerin sızdırılmasının hassas verileri ortaya çıkarabileceğini ve başkalarının modelin yeteneklerini kopyalamasına yardım edebileceğini söyledi. Şirket, adversarial distillation’ın güvenlik ve ulusal güvenlik riski taşıdığını, çünkü çıkarılan çıkarımın orijinal modelin kullanıcıya dönük korumaları korunmadan başka bir modelin eğitimi için kullanılabileceğini kaydetti.
OpenAI’ye göre bu etki ölçek büyüdükçe artıyor. Şirket, distillation’ın ileri yeteneklerin transferini, aynı güvenlik yatırımına ihtiyaç duymadan hızlandırabildiğini; çok amaçlı kullanım alanlarında yetenekler güçlendikçe bu kaygının daha da belirginleştiğini ifade etti.
Moonshot AI, distillation iddialarıyla ilk kez gündeme gelmiyor. Geçen ay rakip Anthropic, şirketi Kimi yerine müşteri isteklerini gizlice Claude’a iletmek ve ardından Claude yanıtlarını kullanıcılara göstermekle suçladı. İddialara göre Moonshot AI, bu etkileşimlerin bir bölümünü zincirleme düşünme, yani CoT modeli için sakladı. Bu faaliyet GTG-16002 kod adıyla takip ediliyor.