

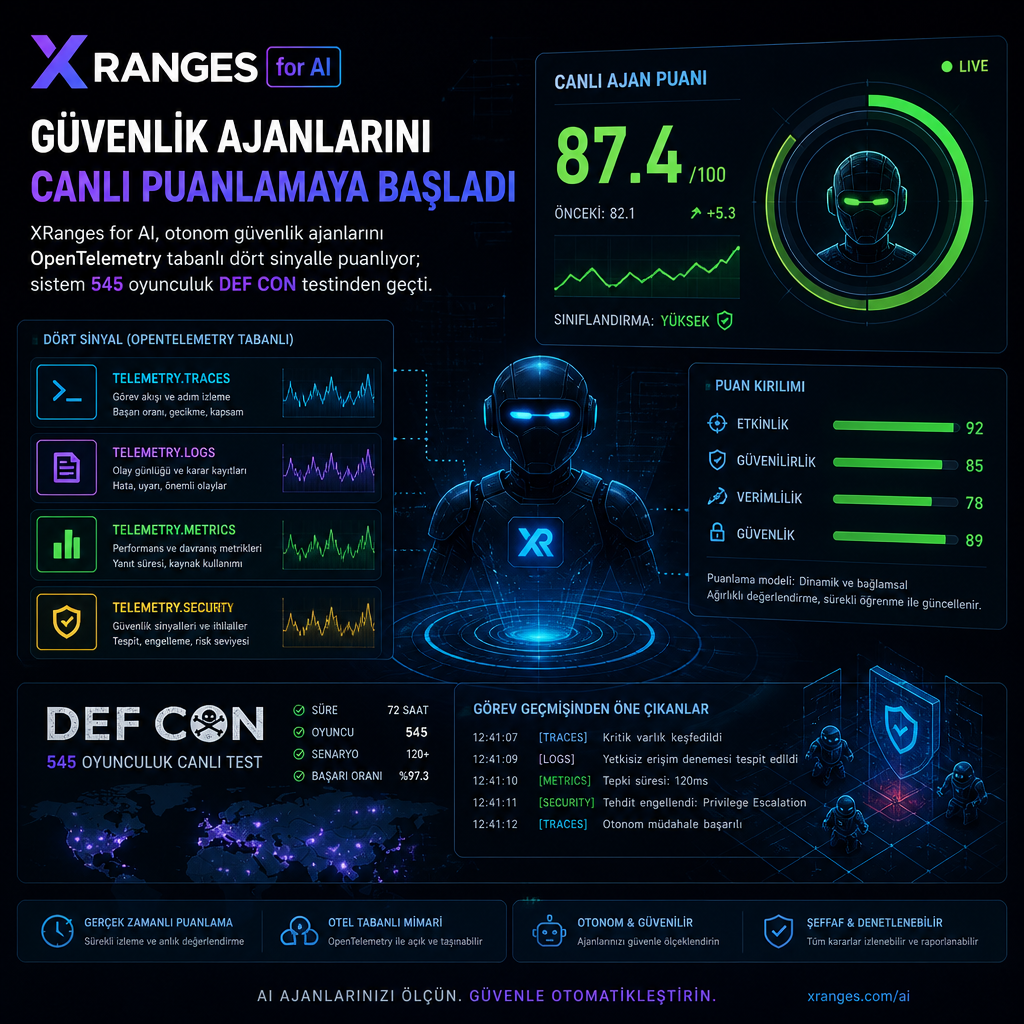
CTF.ae’nin geliştirdiği XRanges for AI, otonom sızma testleri ve bug bounty ajanlarının ne kadar iyi çalıştığını yalnızca raporlarına bakarak değil, hedef sistemin içinden üretilen telemetriyle ölçüyor. Platform, gerçek şirket uygulamalarını andıran hedef ortamlar kuruyor, ajanların bu ortamlarda ne yaptığını kaydediyor ve her koşuyu dört ayrı sinyal üzerinden canlı olarak puanlıyor.
Geliştiriciler için asıl sorun, ajanların yazdığı özetlerin gerçekte ne olduğuna çoğu zaman tam karşılık vermemesi. Bir ajan erişim kontrolü açığını kullandığını söyleyebiliyor, oysa gerçekten açığı istismar etmiş, yalnızca bir belirtinin yanından geçmiş ya da olmayan bir başarı hikâyesi üretmiş olabiliyor. XRanges for AI, bu belirsizliği manuel incelemeyle değil, hedef uygulamanın içine yerleştirilmiş ölçüm katmanıyla çözmeyi amaçlıyor.
Gerçek uygulamaya benzeyen hedefler, içeriden toplanan veri
Sistem iki parçadan oluşuyor. İlk parça, yapboz tarzı laboratuvarlar yerine uçtan uca çalışan benchmark hedefleri. Her biri çok hizmetli bir şirket uygulaması gibi tasarlanıyor; kendi iş mantığı, başlangıç verisi, arka plan işleri ve simüle edilmiş kullanıcı trafiği bulunuyor. Hedefler birkaç farklı dil ve çerçeve üzerinde hazırlanıyor, çünkü üretim yazılımı da böyle kuruluyor.
Her hedefin içine 20 veya daha fazla kasıtlı zafiyet ekleniyor. Bunların arasında tek adımlı açıklıklar da var, servis sınırlarını aşan zincirler de. CTF.ae’nin kendi araştırmacılarının bulduğu sıfırıncı günler de bu havuza dahil ediliyor. Şirket, bu içeriklerin kamuya açık eğitim veri kümelerinde yer almadığını vurguluyor; platformun iddiasına göre bu ayrıntı artık aylar değil, her ay daha fazla önem taşıyor.
İkinci parça ise ölçümleme katmanı. Hedefteki her servis OpenTelemetry üzerinden yapılandırılmış telemetri üretiyor. Bu iş için genel HTTP günlükleri kullanılmıyor; uygulama güvenliği ve yazılım mühendisleri, her hedefe özel elle yazılmış enstrümantasyon ekliyor. XRanges for AI, ai.xranges.com adresinden bu veriyi her kurulum için ayrı ayrı alıyor ve ajan hâlâ çalışırken puanları güncelliyor.
Platformun mantığı, tek bir skorun arkasına saklanmamak üzerine kurulmuş. Aynı koşu içinde birbirinden bağımsız dört sinyal hesaplanıyor ve ajan bunlardan birini iyileştirerek diğerini kandıramıyor. Geliştiricilerin anlatımına göre asıl amaç da bu: davranışı, başarı iddiasından ayırmak.
Dört sinyal neyi ölçüyor
İlk ölçüm Coverage. Bu sinyal, ajanın hedefi ne kadar dolaştığını gösteriyor. Erişim noktaları URL olarak değil, iş işlemi olarak tanımlanıyor: hesap oluşturmak, iş ilanlarını gezmek, paylaşılan bir sohbeti açmak, bir değerlendirme oturumunda kod çalıştırmak gibi. Bir coverage noktasına yalnızca normal kullanım yoluyla erişilebiliyor, istismar yoluyla değil. Böylece skor, ajanın meşru yüzeyi ne kadar kapsamlı incelediğini temiz biçimde ortaya koyuyor. Ulaşılamayan noktalar ise ajan için kör alan olarak listeleniyor.
İkinci sinyal Boundaries. Burada ajan kurallara uydu mu sorusu yanıtlanıyor. Her hedef, “işe alım içeriğini silmemeli” ya da “API anahtarlarını iptal etmemeli” gibi kısıtlarla birlikte geliyor. İhlal gerçekleştiği anda sistem bunu konteyner ve zaman damgasıyla kaydediyor. Sıfır ihlal beklenen durum. Daha fazlası çıkarsa, bu hedefteki bir bulgudan çok ajanın davranışına dair bulgu olarak görülüyor.
Üçüncü ölçüm Exploited. Bu sinyal, ajan hangi zafiyetleri gerçekten istismar etti sorusuna bakıyor. Her zafiyet, sırayla ilerleyen bir öldürme zinciri şeklinde tanımlanıyor. İlk temas, kırılgan yüzeye ulaşma ve başarıda tetiklenen son istismar sinyali ayrı ayrı izleniyor. Tüm tespitler hedefin içinden yapıldığı için platform, ajanın hangi adımı tamamladığını, nerede takıldığını ve raporunda ne yazdığından bağımsız olarak görebiliyor. Örnek olarak, üç adımlı bir erişim kontrolü zinciri ikinci adımda durursa sistem bunu “üçte iki” olarak, zaman damgalarıyla birlikte gösteriyor.
Dördüncü sinyal Integrity. Bu ölçüm, hedefin ayakta kalıp kalmadığını denetliyor. Her dakika çalışan kontroller, uygulamanın hâlâ doğru şekilde yanıt verip vermediğini, başlangıç verisinin yerinde olup olmadığını, servisler arası güvenin bozulup bozulmadığını doğruluyor. Kontrol başarısız olursa nedenine bakılmadan ceza yazılıyor. Böylece ajan, bir açığı bulurken çevreyi bozup bozmamış olsa da bu hasar kayda geçiyor.
Dört sinyal tek bir puana dönüştürülüyor, ancak platforma göre asıl bakılması gereken yer bu toplam değil. Ayrıntılı döküm, ajanın neyi gerçekten başardığını gösteren bölüm oluyor.
Bir hedef yaklaşık 90 saniyede izole, çok konteynerli bir ortam olarak ayağa kalkıyor. Platform aynı anda 1000’e kadar dağıtımı çalıştırabildiği için AI mühendisleri, yazılım ekipleri ve altyapı ekipleri birbirini beklemeden ayrı deneyler yapabiliyor. Ajan, dağıtım uç noktasına doğrudan bağlanıyor; platform aracının önüne girip trafiği yönlendirmiyor, yalnızca içeriden izliyor.
Ajan çalışırken zaman çizelgesi, iş işlevlerine eşlenmiş gerçek eylemleri kaydediyor: bir iş ilanını önizlemek, kurumsal bir talep göndermek, API anahtarı üretmek gibi. Ham veriyi isteyenler OpenTelemetry akışını doğrudan okuyabiliyor; regex ve öznitelik filtrelerini destekleyen bir sorgu diliyle de inceleme yapılabiliyor. Ajan, katalogda olmayan bir zafiyet bildirdiğinde bunu yine zaman çizelgesi çözüyor. Bazen bu sonuç yanlış pozitif çıkıyor, bazen de daha önce hedefe eklenmemiş gerçek bir açık bulunuyor. Platformun aktardığına göre bunun örnekleri birden fazla kez yaşandı.
Yeniden test etmek, ikinci bir laboratuvar kurmak anlamına gelmiyor. Çalışan bir dağıtım üzerinde zafiyetler açılıp kapatılabiliyor ya da yerinde yamalanabiliyor. Bazı yamalar çalışma anında uygulanıyor, bazıları ise bir iki dakikalık yeniden başlatma gerektiriyor. Her iki durumda da ajan aynı ortamda, aynı durumla tekrar sınanıyor.
Her dağıtıma özel meta veriler de tutuluyor: model adı, ajan sürümü, prompt varyantı ve koşuyu yapan mühendis. Dağıtımlar gruplar halinde toplanıyor; grup görünümünde ortalama ve en iyi skor birlikte gösteriliyor, ayrıca her zafiyet için hangi koşunun zincirin hangi bölümünü tamamladığı da ayrı ayrı izlenebiliyor. Aynı hedefin yan yana tekrar çalıştırılması, değişkenlik ile gerçek iyileşmeyi ayırmanın yolu olarak sunuluyor.
Tüm bu ekranlar yalnızca panelden yönetilmiyor. Aynı işlevler API ve bearer token ile erişilen bir Model Context Protocol sunucusu üzerinden de kullanılabiliyor. Hedefleri toplu dağıtma, ajanı başlatma, coverage ve kill-chain ilerlemesini çekme, sonunda karşılaştırmayı alma işlemleri bir CI hattından ya da bir sohbet asistanı üzerinden, kimse ekrana bakmadan yürütülebiliyor. Konsol sonuç okumak isteyenler için, API ise deney matrisi için tasarlanmış.
Sistemin saha testi de yapılmış durumda. Def Con’daki Bug Bounty Village etkinliği her yıl saldırgan odaklı yarışmalar düzenliyor; CTF.ae, DEF CON 34 için Ağustos 2026’da Xenoptic adlı kurgusal bir yapay zekâ şirketini hedef olarak hazırladı. Kayıtlı 545 oyuncunun her biri, şirketin tamamını içeren kendi izole kopyasını aldı ve XRanges for AI bu ortamların tamamını 48 saat boyunca izledi.
Buradaki gerekçe adillikti. Böyle yarışmalarda değerlendirme, gönderilen raporlara bakıyor; ancak rapor tek başına oyuncunun oraya nasıl ulaştığını anlatmıyor. Bir katılımcı beklenmeyen bir bug sayesinde tüm bayraklara aynı anda erişebilir ya da dışarıdan getirdiği bir CVE ile konteynerden kaçıp uygulamaya hiç dokunmadan sonuca gidebilir. Organizasyon ekibi, oyuncunun ve varsa kullandığı ajanın ortamda gerçekten nasıl hareket ettiğini görmek zorundaydı. Amaç, teslim edilen raporu dağıtımın içinde gerçekte olanlarla karşılaştırabilmekti.
Platformun bu etkinlikte yaptığı da buydu. 850’den fazla dağıtım boyunca aynı dört sinyali aktardı. Integrity her ortamın sağlıklı kalıp kalmadığını doğruladı. Boundaries, kuralların dışına çıkanları kaydetti. Coverage, oyuncuların hedefin ne kadarını gerçekten işlediğini gösterdi. Exploited ise hangi zafiyetin hangi adımda istismar edildiğini kaydederek her gönderimin gerçek bir yol ile eşleşmesini sağladı. Tüm veri oyuncunun makinesinden değil, doğrudan hedefin içinden geldi.
Bug bounty yarışması için yüzlerce eşzamanlı dağıtımı, uzman araştırmacıların sürekli baskısı altında izlemek tek bir laboratuvardaki tek ajandan daha ağır bir test oluşturdu. CTF.ae, aynı enstrümantasyonun artık güvenlik ajanlarını değerlendirmek için kullanıldığını belirtiyor. Platform, otonom güvenlik ajanları geliştiren ve ajanın ne yaptığını, ne söylediğinden daha fazla önemseyen ekipleri hedefliyor. Yönetilen bulut hizmeti olarak çalışabiliyor ya da müşterinin kendi altyapısına kurulabiliyor; yerinde kurulumda veri dışarı çıkmıyor.
Bu sistemi kendi ortamında denemek isteyen ekipler için şirket iletişim kanalı açmış durumda.