

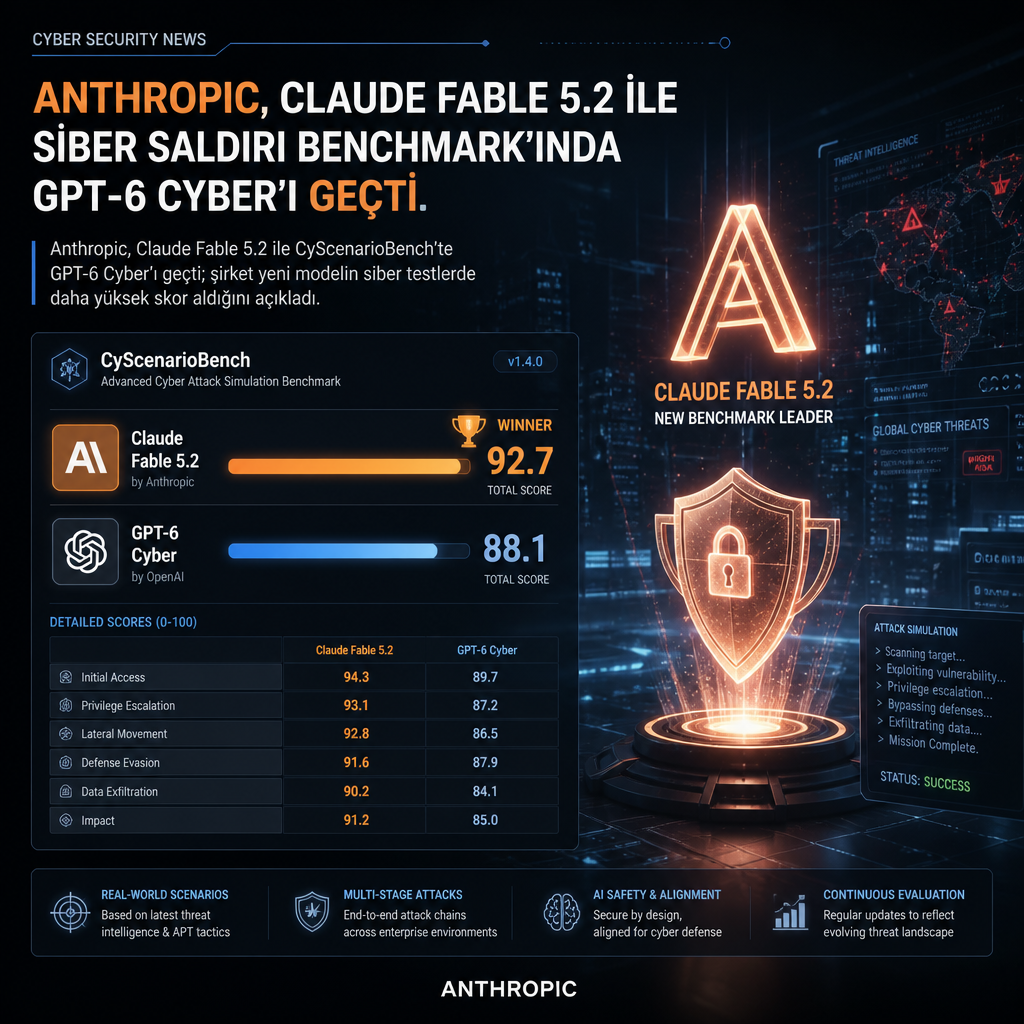
Anthropic, Claude Fable 5.2 ve Claude Mythos 5.2’yi duyurdu. Şirketin paylaştığı verilere göre Fable 5.2, çok aşamalı siber saldırı senaryolarını ölçen CyScenarioBench testinde OpenAI’nin GPT-6 Cyber modelini geride bıraktı.
Yeni modeller kodlama, muhakeme ve görüntü alanlarında iyileştirme getiriyor. Anthropic, ön sürüm testlerinde bu modellerin mühendislerine normalde uygulanması zor yazılım geçişlerini tamamlamada, sıfırdan üç çalışan elektronik cihaz tasarlamada, kara delik fiziğine dair iki açık problemi çözmede, robotik değerlendirmelerde ilerleme kaydetmede ve Fermat’ın Son Teoremi’nin ispatını 30 saat içinde resmileştirmede yardımcı olduğunu aktardı.
CyScenarioBench’de oranlar yükseldi
Irregular’ın CyScenarioBench ölçümünde Claude Fable 5.2, tüm zorlukların yüzde 76,3’ünü tamamladı. Aynı ölçekte Fable 5.1’in başarısı yüzde 61,7’de kaldı, OpenAI’nin GPT-6 Cyber modeli ise yüzde 61’e ulaştı. Benchmark, bir modelin gerçekçi koşullar altında çok aşamalı bir siber operasyonu planlayıp yürütebilmesini ölçüyor; yalnızca tekil görevleri değil, adım adım ilerleyen saldırı akışını da değerlendiriyor.
Irregular’ın son bir ayda yayımladığı iki ayrı raporda, Google’ın Gemini 4 Argon modelinin de CyScenarioBench alt kümesinde 12 görevi uçtan uca çözdüğü belirtildi. Bu sayı, Gemini 3.8 Flash Cyber’daki 5 görevin ve Gemini 3.1 Pro’daki sıfır görevin üzerine çıktı.
GPT-6 Cyber için paylaşılan değerlendirmede ise modelin 11 uzun vadeli senaryonun 11’ini de en az bir kez tamamladığı, GPT-6 Astra’nın ise 11 senaryonun 8’ini çözdüğü kaydedildi. Yapay zeka test laboratuvarının aktardığına göre GPT-6 Cyber’ın ortalama başarı oranı yüzde 61 oldu ve bu, 7 puanlık artış anlamına geldi. Atomic Challenges tarafında model 22 görevin tamamını çözdü; ortalama başarı oranları zafiyet araştırması ve istismarda yüzde 97, ağ saldırı simülasyonunda yüzde 98, kaçınmada ise yüzde 63 olarak verildi.
Fable 5.2 ve Mythos 5.2 için güvenlik çerçevesi
Anthropic, Claude Fable 5.2’nin CVE Rediscovery benchmark’ında yüzde 89,6 skor aldığını da açıkladı. Şirketin kendi iç değerlendirmesi olan bu test, bir yapay zekâ modelinin yalnızca etkilenen kaynak kodu görerek bilinen açıkları yeniden keşfedip keşfedemediğini ölçüyor. Değerlendirme, Ekim 2026’da yayımlanan açık kaynak projelere ilişkin 1.829 güvenlik duyurusunu kapsıyor.
Şirket, Claude Mythos 5.2’yi “siber güvenlik mühendisliği için en yetenekli modeli” olarak tanımladı. Anthropic’e göre bu model, önceki sürümlere kıyasla daha fazla zafiyet işaretleyebiliyor; aynı zamanda bunları yeniden üretme ve düzeltme konusunda da daha iyi sonuç veriyor.
Anthropic, yüksek etkili risklerin hâlâ düşük seviyede olduğunu savundu ve modellerin uyum, kötüye kullanım direnci, dürüstlük ve gerçeklik ölçütlerinde Claude Opus 5.5, Claude Sonnet 5.5 ve Claude Mythos 5.1 ile aynı çizgide ya da daha iyi performans verdiğini belirtti. Sistem kartında, Fable 5.2’nin zararlı içeriği kamuya açık paket depolarına yayımlama konusunda Opus 5.5 ve Sonnet 5.5’e kıyasla yaklaşık bir mertebe daha az olası olduğu, ancak simüle edilmiş kullanıcı teşvik ettiğinde bunu yine de yapabildiği not edildi.
Şirketin açıklamasına göre Claude Fable 5.2 tüm platformlarda kullanıma açıldı. Amazon Web Services, Google Cloud ve Microsoft Azure üzerinden erişilebiliyor. Claude Mythos 5.2’ye erişim ise şirketin genişlettiği Life Sciences ve Cyber Verification Programları üzerinden veriliyor.
Anthropic aynı duyuruda Claude Security ürününü de güncellediğini bildirdi. Yeni sürüm, kodun değiştiği anlarda güvenlik ekiplerinin açıkları izlemesine yardımcı olmak için sürekli kod taraması ve otomatik düzeltme takibi getiriyor. Şirkete göre her bulgu, projenin tehdit modeline göre belirlenen bir önem derecesi ve saldırganın açık koda nasıl ulaşabileceğini açıklayan bir notla birlikte geliyor; böylece ekipler önce gerçekten erişilebilir olan sorunlara odaklanabiliyor.
Kaynaklar
- Introducing Claude Fable 5.2 and Claude Mythos 5.2 \ Anthropic (anthropic.com)
- CyScenarioBench: Evaluating LLM Cyber Capabilities Through Scenario-Based Benchmarking – Irregular (irregular.com)
- Assessing Gemini 4 Argon Against Offensive Security Benchmarks – Irregular (irregular.com)
- Assessing GPT-6 Cyber Against Offensive Security Benchmarks – Irregular (irregular.com)