

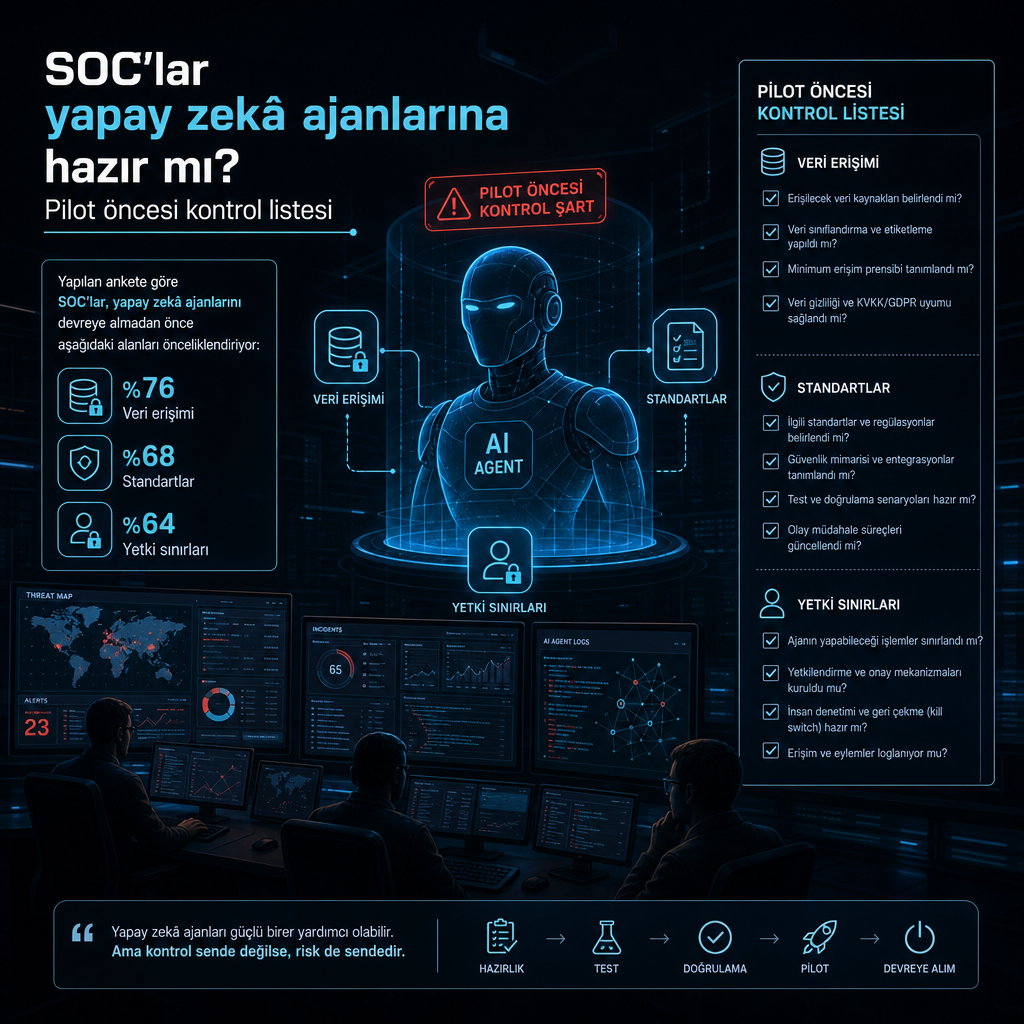
Yayımlanan son değerlendirmelere göre, güvenlik operasyon merkezleri için yapay zekâ ajanları artık yalnızca bir deneme konusu değil; ancak birçok ekip, bu araçları devreye almadan önce kendi SOC yapısının buna hazır olup olmadığını netleştirmek zorunda kalıyor. 250’den fazla CISO, SOC yöneticisi ve uygulayıcıyla yapılan bir araştırma, yapay zekâ destekli SOC ajanlarının en çok alarm yönetimi katmanında fayda sağladığını, fakat bunun için veri erişimi, yazılı inceleme standardı, yetki sınırları ve gözetim kurallarının önceden tanımlanması gerektiğini ortaya koydu.
Raporda, yapay zekâ ajanlarının sadece uyarıları triage eden araçlar olmadığı; SIEM, EDR, kimlik sağlayıcı, bulut ve e-posta sistemlerinden veri çekerek her alarmı ayrı ayrı soruşturabildiği, bulguları kayda geçirdiği ve bazı platformlarda tehdit avı ile deteksiyon mühendisliğine de uzanabildiği aktarıldı. Ancak araştırma, bir SOC’un olgunluk modelinde üst seviyelere çıkmış olmasının şart olmadığını da vurguluyor: ajanlar ilk işi alt katmanda, yani alarm işleme ve inceleme sürecinde yapıyor. Ekiplerin eline geri geçen analiz saatleri ise daha üst katmanlara kaydırılabiliyor.
En büyük fayda, alarm kuyruğunda boğulan ekiplerde
İncelemeye göre yapay zekâ SOC ajanlarından en çok yarar gören ekipler, zaten bir süredir benzer sorunlarla uğraşanlar. Yönetilen algılama ve müdahale hizmeti veren bir MDR ya da MSSP’nin alarmı saatler sonra yükseltmesi, soruşturmayı yeterli bağlam olmadan geri göndermesi ya da kapattığı bir alarmda neye baktığını açıkça göstermemesi, bu tabloya örnek gösterildi. Aynı şekilde, hizmet kapsamının sadece desteklenen EDR ve birkaç log kaynağıyla sınırlı kalması halinde, SaaS uygulamaları veya ikinci bir bulut platformundan gelen alarmlar doğrudan kurum ekibine düşüyor.
Kurum içi analistlerin hem kendi kuyruğunu hem de dış sağlayıcıdan geri dönen alarmları işlemesi durumunda da benzer darboğazlar oluşuyor. Raporda, kritik bir zafiyet ya da yeni bir kampanya gündeme geldiğinde yönetime aynı gün içinde “etkilendik mi” sorusunun yanıtlanmasının çoğu zaman saatler değil günler sürdüğü belirtildi. Bunun nedeni, çevrim içi arama sürecinin SIEM, EDR, kimlik sistemi, bulut konsolu ve e-posta araçları arasında elle dolaşmayı gerektirmesi. Düşük ve orta öncelikli alarmlar ise ya bekliyor ya da toplu şekilde kapatılıyor. Ankete katılanların yüzde 60’ı, daha önce göz ardı edilen veya atlanan bir alarmın daha sonra ihlal ya da kesinti gibi ciddi bir probleme dönüştüğünü söyledi.
Araştırmada ayrıca, gürültülü deteksiyonların zaman baskısı nedeniyle kapatıldığı, avcılık ve deteksiyon mühendisliğinin boş zamanlara bırakıldığı, en zor vakaların bir iki kıdemli analistin omzuna kaldığı ve gece ile hafta sonu vardiyalarının zayıf kaldığı anlatıldı. 7/24 kapsama sağlamak için gereken kadro çoğu bütçede yok; bu yüzden mesai dışı alarmlar sabaha bırakılıyor ya da nöbetçiye gidiyor. Yapay zekâ ajanlarının tasarlandığı yer tam da bu iş yükü. Sistemler, alarm hangi araçtan gelirse gelsin ve saat kaç olursa olsun ilk incelemeyi başlatabiliyor. Ayrıca dış sağlayıcının erişemediği bağlamı kurumun kendi sistemlerinden çekebiliyor, ulaştığı sonucun arkasındaki kanıtı kaydedebiliyor ve bazı platformlarda yeni bir tehdit açıklandığı gün otomatik av çalıştırabiliyor.
Rapor, bu nedenle bir SOC’un ilk önce neye ihtiyaç duyduğunu saptamasını öneriyor. Yapay zekâ ajanları, kurumda hâlihazırda bulunan sorunları hedef aldığında en fazla faydayı veriyor; fakat bu faydanın üretim ortamına taşınması için ekibin teknik olarak da hazır olması gerekiyor.
Hazırlık üç temel alanda ölçülüyor: erişim, standart ve yetki
Yapay zekâ ajanı yalnızca sorgulayabildiği veriyi görebiliyor. Bu nedenle API erişimi, hazırlığın ilk şartı olarak öne çıkıyor. Bir ajan EDR’ye erişebiliyor ama kimlik sağlayıcıya erişemiyorsa, uç noktada ne olduğunu anlatabilir; fakat bunun arkasında hangi hesabın bulunduğunu çıkaramayabilir. Aynı mantık SIEM, kimlik altyapısı, bulut platformları, e-posta ve kritik SaaS uygulamaları için de geçerli. Ayrıca varlık kritikliği, kullanıcı rolleri, VIP listeleri, iş birimleri ve planlı taramalar ya da yönetici betikleri gibi meşru davranışlar da okunabilir biçimde tutulmalı. Aksi halde sistem, saldırgan etkinliği ile yasal yönetici işlemini ayırt etmekte zorlanıyor. Log borularının sağlıklı işlemesi de bu denklemin parçası; sessiz ya da gecikmeli bir kaynak, soruşturmanın tamam görünüp aslında eksik kalmasına yol açabiliyor.
Metinde, veri erişimi konusunda en sık gündeme gelen itirazın gizlilik olduğu da yer aldı. Ankette katılımcıların yüzde 44’ü, veri gizliliğini ve yapay zekâ modellerinin nasıl eğitildiğini en büyük engel olarak gösterdi. Bu nedenle satıcıya, kurum verisinin modeli eğitmek için kullanılıp kullanılmadığının ve verinin nerede işlendiğinin açıkça sorulması gerektiği vurgulandı.
Hazır bir pilot için ikinci kritik başlık, tamamlanmış bir soruşturmanın ne demek olduğunun yazılı hale getirilmesi. Birçok SOC’da bu standart yalnızca kıdemli analistlerin kafasında bulunuyor. Oysa phishing vakasında hangi kanıtın kapanış için yeterli sayıldığı, “impossible travel” uyarısında kullanıcı yöneticisinin ne zaman aranması gerektiği ya da bir alarmın ne zaman zararsız kabul edileceği, yazıya dökülmesi gereken kurallar arasında. Bu belge, en çok gelen alarm türleri için aynı zamanda yeni analistler adına bir eğitim dokümanı işlevi görüyor.
Kuruluşların ayrıca kapatılan deteksiyonların listesini de tutması gerekiyor. Ankette organizasyonların yüzde 40’ına kadarında, onları denetleyecek insan olmadığı için bazı algılamaların kapatıldığı ifade edildi. Yapay zekâ ajanı tüm alarmları incelemeye başladığında, bu kuralların bir kısmı yeniden devreye alınabiliyor; liste de nereden başlanacağını gösteriyor. Araştırma, temel ölçütlerin de pilot öncesi kayda geçirilmesini istiyor: incelenen alarm oranı, ortalama inceleme süresi, alarmdan ilk bakışa kadar geçen süre ve kapatılan alarmların ne sıklıkla yeniden açıldığı. Raporda, kapsamlı bir incelemenin ortalama 75 dakika sürdüğü ve alarmların çoğu zaman yaklaşık bir saat boyunca kimse açmadan beklediği bilgisi de verildi.
Yetki tarafında ise inceleme ile müdahale ayrı riskler olarak ele alınıyor. Ankete katılan ekiplerin yüzde 57’si, bir alarm kapatılmadan önce her yapay zekâ kararının insan tarafından incelenmesini şart koşuyor. Müdahale tarafında yüzde 44’lük kesim, yapay zekânın eylem önerisini üretip uygulamayı insanlara bırakıyor. Yüzde 30’u ise düşük riskli düzeltmeleri sisteme kendi başına yaptırıyor. Tam ve gözetimsiz otonomi veren tek bir ekip bile yok.
Bu aşamada yazılması gereken kurallar arasında, varsayılan onay modeli, hangi eylemlerin insan onayında kalacağı, ajan yetkisinin kim tarafından ve hangi performans eşiğinden sonra genişletileceği, bulguların hangi vaka yönetim veya ticketing araçlarına düşeceği ve hata yaptığında geri bildirimi kimin yöneteceği yer alıyor. Kaynakta, başta host izolasyonu, hesap devre dışı bırakma ya da alan adı engelleme gibi eylemlerin insan onayında tutulması gerektiği belirtiliyor. İlk aşamada sadece okuma yetkisiyle başlamak, güven arttıkça kademeli olarak izinleri genişletmek, yeni bir insan analisti sisteme dahil ederken uygulanan yaklaşımla aynı mantıkta sunuluyor.
Prophet Security’nin SOC olgunluk modelinde beş katman bulunuyor: alarm yönetimi, algılama kapsamı, tehdit farkındalığı, proaktif avcılık ve duruş iyileştirme. Her katman altındaki seviyeye dayanıyor. Alarm altında ezilen bir ekip avcılığa geçemiyor; tehdit farkındalığı olmayan bir ekip de neyi araması gerektiğini net bilmiyor. Yapılan son analizde, katılımcıların yüzde 28’inin hiçbir zaman incelenmeyen alarm oranı taşıdığı da aktarıldı.
Yapay zekâ ajanlarının çoğu ilk katmanda devreye giriyor, yeni platformların bir bölümü ise avcılık ve deteksiyon önerisiyle ikinci ve dördüncü katmanlara uzanıyor. Bu nedenle hazırlık, ilk katmanın neye ihtiyaç duyduğuna göre şekilleniyor. Kurumun önce erişim boşluklarını kapatması, ardından kendi en yoğun alarm türleri için soruşturma standartlarını yazması, sonra da ajanı bir süre analistlerle paralel çalıştırması öneriliyor. Bu sırada her analist müdahalesi, ajanın hangi noktada daha fazla bağlama ihtiyaç duyduğunu gösteren veri olarak ele alınıyor.
Rapor, bazı ekiplerin hazır olmadıkları halde kendi ajanlarını sıfırdan geliştirmeye yöneldiğini de not ediyor. Ankete göre yapay zekâ kullanıcılarının yüzde 72’si kurum içi araç geliştirmeyi denemiş; bu projelerin yüzde 46’sı ise yarım kalmış, üretime çıkamamış ya da ticari bir ürünle değiştirilmiş. Çünkü çalışan bir prototipin ötesinde asıl yük, entegrasyonların bakımı, API değişiklikleri, hız limitleri, altı ila dokuz ayda bir gelen model değişimleri, prompt injection testleri ve her alarmın neden kapatıldığını açıklayan denetim kayıtları gibi alanlarda ortaya çıkıyor.
Kaynak metin, ajanlı SOC yaklaşımını özetlerken soruşturma, tehdit avı ve deteksiyon mühendisliği görevlerini ayrı uzman ajanlara paylaştıran bir yapıdan söz ediyor. Analist ajanı her seviyedeki alarmları 7/24 inceliyor, SIEM, EDR, kimlik, bulut ve e-posta araçlarından doğrudan sorgu çalıştırıyor ve vardığı sonucun arkasındaki tüm soru, sorgu ve kanıtı kaydediyor. Müdahale yalnızca müşterinin tanımladığı yetkilerle yapılıyor; varsayılan model ise insan onayı. Tehdit avı ajanı, yeni bir tehdit ortaya çıktığında “etkilendik mi” sorusuna yanıt üretmek için otomatik avlar koşuyor, planlı avları ve ekip tarafından doğal dille yazılan soruları belirlenen periyotta çalıştırıyor. Şüpheli izler daha sonra ayrıntılı inceleme için analist ajanına aktarılıyor.
Deteksiyon mühendisi tarafı ise boşta kalan iş yükünü alıyor. Sistem, kurumun kendi soruşturmalarından beslenen canlı bir MITRE ATT&CK kapsama haritası tutuyor; hangi tekniklerin kapsandığını, hangilerinin sessizleştiğini ve hangilerinin karanlıkta kaldığını gösteriyor. Buradan çıkan bulgularla yeni algılamalar oluşturuluyor, SIEM ya da kullanılan aracın kural diline göre yazılıyor ve kurumun kendi geçmiş verileri üzerinde geriye dönük test ediliyor. Her değişiklik, gerekçesi ve backtest sonucu görülebilen bir öneri olarak sunuluyor; varsayılan olarak hiçbir şey ekip onayı olmadan üretime geçmiyor.
Platformun iddiasına göre soruşturmalar, avlar ve kapsama açıkları birbirini besliyor; toplanan veriler neyin gürültü ürettiğini ve nerede boşluk olduğunu gösteriyor. Müşteri verilerinin modelleri eğitmek için kullanılmadığı, veri katmanının ise müşterinin kendi VPC’si içinde çalışabildiği de metinde yer alıyor. Raporun tamamı, burada atıf yapılan 2026 çalışmasındaki anket verileriyle birlikte indirilebilir olarak sunuluyor.